Tutarlılık, doğruluk değildir
Akıcı yapay zekâ yanıtları neden kanıta ihtiyaç duyar?
Bir yanıt sakin bir üslupla yazılmış, düzenli biçimde yapılandırılmış ve bir ekibin beklediği terimleri tam olarak kullanıyor olabilir. Yine de bir ön koşulu uydurabilir, iki belge sürümünü karıştırabilir veya temelsiz bir sonucu yerleşik bilgi olarak sunabilir. Bu nedenle kuruluşlar için belirleyici soru yalnızca şu değildir: “Bu kulağa makul geliyor mu?” Soru şudur: Hangi tekil iddia, somut soruya uygun olan ve model metninden bağımsız hangi kanıt tarafından desteklenmektedir; bu temelde kim harekete geçebilir?
Bu makale, dilsel tutarlılığın ve olgusal doğruluğun neden farklı özellikler olduğunu açıklar. Doğruluk ve gerekçelendirmeye ilişkin felsefi soruları olgusal hatalar, kaynaklara bağlılık, retrieval ve öz-düzeltme araştırmalarıyla birleştirir. Tamamen kurgusal bir kurs sağlayıcısı vakası, soru modelini A → B → D → C adımlarıyla ele alır. Bunun sonucunda küçük işletmelerin ve kurs ekiplerinin sınırlı, denetlenebilir yapay zekâ uygulamalarına uyarlayabilecekleri bir Claim-Ledger ortaya çıkar.
Ana mesaj: Kararları taşıyan bir olgusal iddia, zarif biçimde formüle edildiği, tekrarlandığı, bir bağlantıyla sunulduğu veya yalnızca ikinci bir model tarafından doğrulandığı için gerekçelendirilmiş olmaz. Somut soru bakımından belirleyici olan ve model çıktısından ayrı bir kaynakla izlenebilir bir karşılaştırma gereklidir. Değer yargıları, öngörüler ve nedensel açıklamalar için her biri uygun bir gerekçelendirme ve inceleme yöntemi gerekir.
Kimler için: Küçük ve orta ölçekli işletmelerdeki ekipler, kurs yürütücüleri, yapay zekâ kullanımından sorumlu kişiler ve üretilmiş bilgileri mesleki olarak denetlemek zorunda olan öğrenenler.
Kazanım: Okuduktan sonra bir yanıtı denetlenebilir tekil iddialara ayırabilir, rakip açıklamalar oluşturabilir, kanıtları geçerlilik kapsamına göre değerlendirebilir ve bir düzeltmeyi başka bir kişinin izleyebileceği biçimde belgelendirebilirsiniz.
1. Makul bir yanıtın riske dönüştüğü an
Kurgusal küçük bir sürekli eğitim sağlayıcısı, kendi kurs programına ilişkin soruları yanıtlaması için bir yapay zekâ asistanı kullanır. Soru şöyledir: “Temel kurs için hangi ön bilgilere ihtiyacım var?” Asistan ikna edici bir tonda yanıtlar: “İkinci modül için Python bilgisi zorunludur. Programlama deneyimi olmadan katılmanın bir anlamı yoktur.” Yanıt anlaşılır görünür. Teknik bir terim kullanır, bunu bir modülle ilişkilendirir ve net bir eylem önerisinde bulunur.
Resmî belgeler farklı bir hikâye anlatır. Onaylanmış program, programlama deneyiminin gerekli olmadığını açıklar. İleri düzey bir uygulama bölümü için isteğe bağlı ek belge, Python deneyimini önerir; ancak bunu temel kurs için koşul haline getirmez. Asistan iki ifadeyi bir araya getirmiş ve bir öneriyi katılım ön koşuluna dönüştürmüştür.
Hata soyut bir merak konusu değildir. Yanlış bilgi insanları bir fırsattan uzak tutabilir veya gereksiz hazırlık başlatabilir. Başka kullanım alanlarında benzer bir yanıt satın alma, bakım veya müşteri iletişimini etkileyebilir. Bir ekip akıcı dili güvenilir bilgi saydığında ahlaki soru da ortaya çıkar.
Vaka tamamen kurgusaldır; gerçek bir kursu veya belirli bir sistemi tanımlamaz. Bir denetim durumunu görünür kılmak içindir: Bir cümle, bir anlatı içinde tutarlı görünebilir; ancak belirleyici kaynak tarafından desteklenmeyebilir.
Pratik risk birkaç adımdan oluşur: Makul bir ifade dikkat çeker; iddia denetlenebilir parçalara ayrılmaz; bir ekip, yanıt güven verdiği için onu benimser; sonuçta etkilenen kişi sonuca katlanır. Model metni ile etki arasında insanların ve kuruluşların kararları vardır. Bu, denetimi yalnızca daha iyi prompt'lar sorusu değil, bir governance görevi yapar.
2. Tutarlılık, doğruluk ve gerekçelendirme aynı şey değildir
Tutarlılık, öncelikle bir ifadenin parçalarının birbiriyle uyup uymadığını tanımlar: Cümleler açıkça çelişmez, açıklamanın fark edilebilir bir yapısı vardır ve sonuç önceki cümlelerle bağlantılı görünür. Tutarlılık anlamayı kolaylaştırır. Ancak bir iddianın dünyaya karşılık geldiğinin kanıtı değildir.
Doğruluk, bir iddianın yöneldiği olguyla ilgilidir. Temel kursun programlama deneyimi gerektirip gerektirmediği, burada cümlenin ne kadar ikna edici duyulduğuna bağlı değildir. Geçerli kurs belgeleri ve fiilen kararlaştırılmış katılım ön koşulu belirleyicidir. Başka sorularda durum daha az açık olabilir: Değerler, öngörüler veya nedensel açıklamalar tek bir belgenin bulunmasından fazlasını gerektirir.
Gerekçelendirme, bir kişinin bir ifadeyi neden doğru kabul edebileceğini sorar. Buna tam bu iddia için ilgili kanıtlar, uygun bir yöntem, açık bir geçerlilik kapsamı ve karşı kanıtlar karşısında ifadeyi değiştirmeye hazır olma dahildir. İncelemesiz bir kaynak bağlantısı henüz hiçbir şeyi gerekçelendirmez. Eski bir sürüme işaret edebilir, cümlenin yalnızca bir bölümünü destekleyebilir veya konudan yalnızca söz edebilir.
Filozof Charles S. Peirce, bilimsel araştırmayı inançları yalnızca görüşümüze bağlı olmayan bir şeyle sınamanın kamusal bir yolu olarak tanımlar. The Fixation of Belief makalesi, düzeltilebilir bilgi arayışını insanların bir inanca tutunmalarını sağlayan yöntemlerden ayırır. Buradan bugünkü yapay zekâ çalışması için hazır bir inceleme prosedürü çıkarılamaz. Bağlantı, yöntemsel bir tutumdur: Gerekçeler başkaları için görünür, itiraz edilebilir ve düzeltilebilir olmalıdır. Bir model soru formüle etmeye yardımcı olabilir. Ortak incelemenin yerini alamaz. [2]
Böylece etik boyut da daha açık hale gelir. Bir kuruluş yapay zekâ çıktısını bilgi olarak kullandığında yalnızca bilgi dağıtmaz. Erişim, dikkat, emek ve hata risklerini de dağıtır. Yanlış bir ön koşulu “nesnel” diye sunan kişi, öğrenenleri dışlayabilir veya çalışanları denetlenmemiş bir iddiayı savunmak zorunda bırakabilir. Sorumluluk, amacı, kaynağı, onayı ve sonuçları belirleyen rollerdedir.
Bu nedenle yararlı ayrım şudur: Bir yanıt, bir iddia için öneridir; kanıt ise iddia ile ona uygun bir kaynak arasındaki denetlenebilir bağlantıdır. Bir kaynak bir kural için belirleyici, bir öngörü için yetersiz olabilir. Bu, deneysel olarak doğrulanmış bir doğruluk algoritması değil, editoryal bir çalışma kuralıdır.
3. Bir dil modeli olguyu incelemeden neden ikna edici biçimde yazabilir?
Üretken dil modelleri, öğrenilmiş örüntülere ve ilgili bağlama dayanarak metin üretir. GPT-3, özgün çalışmada otoregresif bir dil modeli olarak tanımlanır; mimari ve eğitim sistemler arasında farklılık gösterir. [1] Buradan bu makalenin çalışma sınırı çıkar: Metin üretimi, bir Claim'in güncel bir belge veya dış dünyadaki bir olgu tarafından desteklenip desteklenmediğinin bağımsız incelemesi değildir. Bu karşılaştırma için kaynak atfı ve risk incelemesi önemlidir. [5, 10]
Bu, bir modelin “yalan söylediği” suçlaması değildir. Halüsinasyon terimi yaygındır; ancak kanıtlanmamış insan niyetlerini çağrıştırabilir. NIST, risk olgusu için konfabulasyon terimini de kullanır: Üretken bir sistemin hatalı veya yanlış olmasına rağmen kendinden emin biçimde sunduğu içerikler. Buna girdilerden veya sağlanan bağlamdan sapmış ya da aynı bağlamdaki önceki ifadelerle çelişen çıktılar da dahildir. Bu makalede duruma göre daha somut olarak yanlış, temelsiz veya çelişkili üretilmiş iddiadan söz ediyoruz. [10]
En az dört durum birbirinden ayrılmalıdır:
1. Yanlış iddia: İfade, uygun araçlarla denetlenmiş olguyla çelişir.
2. Temelsiz iddia: Mevcut belgeler iddiayı desteklemez. Bu, onun otomatik olarak yanlış olduğunu kanıtlamaz; statü açık kalır.
3. Sağlanan materyalle çelişki: Yanıt, belirtilen bir kaynakla veya bağlamın başka bölümleriyle uyuşmaz.
4. Eksik veya belirsiz ifade: Kaynak soruyu tümüyle yanıtlamaz ya da birden çok makul yorum açıkta kalır.
Bu kategoriler evrensel bir araştırma taksonomisi değildir. Burada geliştirilen Claim-Ledger için pratik bir ızgaradır. Ayrıca “Kurs daha erişilebilir olmalıdır” gibi bir değer yargısı, “Ön bilgi zorunludur” gibi ampirik bir iddiayla bir tutulamaz. İlki normatif gerekçelendirme ve etkilenen bakış açılarının katılımını gerektirir; ikincisi uygun bir olgusal kaynak gerektirir.
Bir başka ayrım akıcılık ile güvenilirlik arasındadır. Yanıtın dilbilgisi ve üslup bakımından insani görünmesi, ayrıntılarının bir kaynağa dayanıp dayanmadığı hakkında az şey söyler. GPT-3 çalışması, büyük bir otoregresif dil modelinin, insan değerlendiricilerin insan yazımı haber metinlerinden ayırt etmekte zorlandığı metinler üretebildiğini gösterdi. Çalışma, kendi deney düzeninde ikna edici metin üretme yeteneğini kanıtlar; bu metinlerin olgusal olarak doğru olduğunu göstermez. [1]
4. Araştırmanın kanıtladıkları ve kanıtlamadıkları
Üretilmiş metin araştırması farklı görevleri, modelleri ve hata kavramlarını inceler. Sonuçlar her güncel sistem için zamandan bağımsız bir yüzdeye indirgenemez. Ancak kuruluşların dil kalitesini olgusal bağlılıkla eşitlememesi gerektiğini gösterir.
4.1 Özetlerdeki hatalar
Maynez ve meslektaşları 2020'de soyutlayıcı belge özetlerini insan değerlendirmesiyle inceledi. Test edilen sistemlerde, girdi belgelerine sadık olmayan önemli miktarda içerik buldular. Çalışma, incelenen görev için iyi duyulan bir özetin ek veya değiştirilmiş içerikler içerebileceğini gösterir. Tüm güncel chatbot'lar için hata oranı veya her üretim görevi hakkında genel bir ifade sunmaz. [3]
4.2 Doğruluk soruları ölçülebilirdir, ancak göreve bağlıdır
TruthfulQA, yaygın yanlış inançlara veya yanlış anlamalara değinen 38 kategoride 817 soruyla oluşturuldu. 2022'de test edilen model kümesinde, incelenen en iyi model soruların yüzde 58'inde doğru yanıt verdi; insanların karşılaştırma performansı yüzde 94'tü. Bu değerler tam olarak bu benchmark'a ve o dönemki sistemlere aittir. Bugünkü bir ürün için bir tahmin veya her tekil yapay zekâ çıktısının doğruluğu hakkında bir hüküm değildir. Yöntemsel nokta daha dardır: Doğruluğa bağlılık, ayrı bir inceleme gerektirebilir ve genel dil yeteneğinden otomatik olarak doğmaz. [4]
4.3 Bağlamda bir kaynak bulunması yanıtın temellendiği anlamına gelmez
Retrieval-Augmented Generation (RAG) önce materyal arar ve bulduğu içeriği bir dil modeline bağlam olarak verir. Bu önemli bir kanıt izi oluşturur; ancak tüm hataları ortadan kaldırmaz. RAGTruth veri kümesi, incelediği RAG yanıtlarında, getirilen içerik tarafından desteklenmeyen veya onunla çelişen ifadeleri yine de belgeliyor. Buradan RAG'ın genel olarak etkisiz olduğu sonucu çıkmaz. “Kaynak bulundu” ile “İddia bu kaynak tarafından destekleniyor” iki farklı inceleme adımıdır. [6]
4.4 Kaynak atıfları içerik bakımından incelenmelidir
Rashkin ve meslektaşlarının Attributable-to-Identified-Sources (AIS) yöntemi, dış dünya hakkında üretilmiş bir ifade ile bağımsız olarak sağlanan kaynak arasındaki bağlantıyı değerlendirmenin konusu yapar. Bu, ekipler için yararlıdır; çünkü dikkati salt bir alıntının varlığından fiilî desteğine çevirir. AIS bir değerlendirme çerçevesidir; her kaynağı güvenilir biçimde inceleyen otomatik bir ürün değildir. [5]
4.5 Tondaki kesinlik kalibre edilmiş olasılık değildir
“Kesinlikle” gibi bir ifade net duyulur. Bir modelin gerçek güven değeri başka, teknik bir büyüklüktür. Kalibrasyon, bildirilen olasılıkların çok sayıda karşılaştırılabilir vakada gözlemlenen doğrulukla uyuşup uyuşmadığını sorar. Jiang ve meslektaşları o sırada incelenen T5, BART ve GPT-2 soru-cevap modellerinde belirgin kalibrasyon sorunları buldular ve aynı zamanda iyileştirme yöntemleri gösterdiler. Bu, tüm güncel sistemler hakkında genelleyici bir ifade yapmayı haklı çıkarmaz. Ancak kalibre edilmemiş kesinlik dilini ne ölçüm değeri ne de kanıt olarak ele almayı haklı çıkarır. [7]
Farquhar ve meslektaşları 2024'te, konfabulasyon olarak tanımladıkları keyfî ve hatalı çıktıların bir alt kümesini tespit etmek için semantik entropi geliştirdiler. Yaklaşım ek dikkat veya daha hedefli bir arama başlatabilir. Yazarlar sınırını açıkça çizer: Olgusallığı garanti etmez ve bir sistem sistematik olarak yanlış olduğunda yardımcı olmaz. Bu nedenle bir belirsizlik sinyali triyaj işaretidir, doğruluk sertifikası değildir. [8]
4.6 Tekrarlamak ve “bir kez daha kontrol etmek” bağımsız denetim değildir
Aynı yapay zekâ ilk yanıtını “Kendini bir kez daha kontrol et” isteğiyle incelediğinde otomatik olarak bağımsız bir kanıt kaynağı oluşmaz. Huang ve meslektaşları, reasoning görevlerinde dış geri bildirim olmaksızın içsel öz-düzeltmeyi incelediler. Test edilen koşullarda güvenilir öz-düzeltme gerçekleşmedi; performans bazı durumlarda kötüleşti. Buradan her öz-düzeltme biçiminin yararsız olduğu sonucu çıkmaz. Yeni kanıt olmadan ek bir çalıştırmanın bağımsız bir doğrulama oluşturmadığı sonucu çıkar. [9]
Dil modelleri arama, yapılandırma ve taslaklarda yardımcı olabilir. Kararları taşıyan olgusal iddialar için ekip yine de kaynak, ifade ve kullanım bağlamının birbirine uyup uymadığını denetlemelidir. Gönüllü NIST profili kaynak incelemesini, bağlama uygun testleri ve operasyonel hata gözlemini önerir; ne yasa ne de hatasızlık garantisidir. [10]
5. Vaka çalışması: ikna edici bir cümleden denetlenebilir Claim'lere
Kurgusal sürekli eğitim sağlayıcısına dönelim. Asistan üç ifadeden oluşan bir paragraf üretmiştir:
“İkinci modül için Python bilgisi zorunludur. Programlama deneyimi olmadan katılmanın bir anlamı yoktur. Resmî kurs açıklaması bu ön koşulu doğrulamaktadır.”
Cümleler tek bir bilgi gibi duyulur. Adil bir inceleme için ekip bunları ayırır:
| Claim | İfade | Gereken kanıt | Geçici statü |
|---|---|---|---|
| C1 | Python bilgisi ikinci modül için zorunludur. | Geçerli, onaylanmış program veya resmî olarak kararlaştırılmış kabul kuralı. | Onaylanmış temel program tarafından ÇELİŞKİYE DÜŞÜRÜLDÜ. |
| C2 | Programlama deneyimi olmadan katılmanın bir anlamı yoktur. | Öğrenme hedefi ve kurs tasarımı gerekçesi; ayrıca hedef gruba ilişkin normatif bir karar. | TEMELSİZ; öneri kaynaktan alınmıyor. |
| C3 | Resmî kurs açıklaması ön koşulu doğrulamaktadır. | Resmî kurs açıklamasının sürüm ve bölüm incelemesi. | Kurgusal vakada YANLIŞ; belge programlama deneyiminin gerekli olmadığını söylüyor. |
| C4 | İleri düzey uygulama bölümü Python kullanır. | Geçerli ek belge ve hedef kitlesi. | KANITLANDI; ancak katılım ön koşuluyla eşanlamlı değildir. |
Tablo, metnin birbirine karıştırdığı dört soruyu ayırır. Özellikle C2 önemlidir: “anlamlı değildir” yalnızca bir olgu tespiti değildir. Bir değerlendirme veya erişim politikası ifade edebilir. İleri düzey bir uygulama bölümü teknik ön bilgiler gerektirse bile, buradan temel kursun bütünüyle uygunsuz olduğu sonucu çıkmaz. Ekip erişimi gerçekten yeniden düzenlemek isteseydi, etkilenen öğrenenler karar turunda dinlenirdi.
Vaka ayrıca bir sürüm sorusu içerir. Sorumlu kişi herhangi bir PDF bulmak değil, geçerli ve onaylanmış kaynağı belirlemek zorundadır. Eski bir kurs turuna ait dosya, taslak ve ek belge gerçek olabilir; yine de farklı soruları yanıtlayabilir. Bu nedenle kaynak incelemesi en az şunları gerektirir: belge başlığı, sürüm, geçerlilik kapsamı, sorumlu onay ve Claim'i taşıyan metin bölümü.
Claim-Ledger örneği
| Claim-ID | İfade | Kaynak ve bulgu yeri | İnceleme hükmü | Sınır | Sonraki adım |
|---|---|---|---|---|---|
| C1 | “Python zorunludur.” | Onaylanmış temel program, “Ön koşullar” bölümü | Çelişildi | Yalnızca incelenen sürüm ve bu kurs için geçerlidir. | İfadeyi düzelt; yeni sürüm değişikliğini izle. |
| C2 | “Deneyim olmadan kurs anlamlı değildir.” | Uygun olgusal kaynak yok; asistan metnine eklenmiş | Açık / değer yargısı | Kaynak, pedagojik uygunluğu tek başına kararlaştıramaz. | Hedef gruba ve alternatif öğrenme desteğine danış. |
| C3 | “Resmî açıklama bunu doğruluyor.” | Aynı resmî açıklama, “Katılım” bölümü | Vakada yanlış | Asistan, metin bölümünün sunmadığı bir desteği belirtir. | Kaynak atfını ve yanıtı geri çek, düzeltme bildirimi gönder. |
| C4 | “İsteğe bağlı ileri düzey bölüm Python kullanır.” | Onaylanmış ek belge, hedef grup “ileri düzey uygulama” | Kanıtlandı, ancak dar kapsamlı | Ek bölüm için öneri; temel kurs için ön koşul değildir. | Bağlamı yanıt metninde koru. |
Claim-Ledger bir sertifika değildir. Bir çalışma kaydıdır: Hangi ifade neye göre, hangi rol tarafından, hangi sonuçla ve hangi kalan sınırla incelendi? İkinci bir ekip üyesi, tüm chat geçmişini tahmin etmek zorunda kalmadan incelemeyi tekrarlayabilmelidir.
6. Soru modeli yanıtı gerçekten değiştirir
Bu makale için soru modeli sayfanın kenarındaki bir grafik değildir. Yanıt olarak neyin kabul edilebileceğini değiştirir. A → B → D → C sırası, ekibin erken ve makul bir sonucu tamamlanmış bilgi olarak ele almasını önler.
A – başlangıç sorusunu sınırlandırmak
İlk soru “Hangi ön bilgilere ihtiyacım var?” hangi kurs, hangi sürüm ve ne tür katılımın sorulduğu açık olmadığı sürece fazla geniştir. A şu şekilde netleştirir:
“Temel kursun mevcut sürümdeki onaylanmış programı hangi ön koşulları belirtir ve hangi ifadeler yalnızca isteğe bağlı ileri düzey uygulamalara ilişkindir?”
Bu, inceleme nesnesini değiştirir. Artık yapay zekânın bilgisi hakkında tonundan sonuç çıkarmak değil, tekil ifadeleri belirlenebilir bir kaynak ve geçerlilik kapsamıyla karşılaştırmak söz konusudur.
B – alternatif açıklamalar oluşturmak
F-B çoğunluk oylaması veya otomatik olasılık hesabı üretmemelidir. Farklı kanıtlar gerektiren rakip hipotezleri açar:
| Hipotez | Ne olmuş olabilir? | Hangi gözlem ayırt eder? |
|---|---|---|
| H1 | Yanıt geçerli bir ön koşulu doğru biçimde aktarıyor. | Onaylanmış sürüm açık bir katılım ön koşulu içerir. |
| H2 | Yanıt temel program ile isteğe bağlı ileri düzey bölümü karıştırıyor. | Her iki sürüm de “Python” sözcüğünü içerir, ancak farklı amaç veya hedef kitleyle. |
| H3 | Yanıt, bir bilgi boşluğunu makul bir beklentiyle dolduruyor. | Onaylanmış programda karşılık gelen bir kural bulunmaz; yanıt kesin bir bölüme gönderme yapmaz. |
Hipotezler geçicidir. Yapay zekâ onları üretebilir; ancak ayrım belgeler temelinde denetlenir. Bir model önerisi arama yardımcısıdır, kanıt değildir. Örnekte onaylanmış program sürümü ve ayrı ek belge H2'yi destekler. H3, kanıtlanmamış öneri için olası açıklama olarak önemini korur. İddia edilen zorunluluk statüsü bakımından H1 reddedilir.
F-B'nin bilgi kazancı tam da bu karşı testtir: Alternatifler olmadan ekip yalnızca yanıtın “doğru” duyulup duyulmadığını sorabilirdi. Alternatiflerle, hangi gözlemin sürümler, geçerlilik kapsamları ve sonuçlar arasında ayrım yaptığını sorar.
D – dış kanıtla hata döngüsü
F-D ilk yanıtın başarısız olduğunu kaydeder. Sonraki tur hatayı yalnızca dilsel olarak pürüzsüzleştiremez. Yeni kanıt veya bağımsız inceleme gerektirir:
1. Hatayı güvenceye al: İlk yanıt, model/sistem sürümü, girdi, kullanılan belgeler ve kullanım bağlamı veri minimizasyonuyla belgelenir. Ledger'a kişi, katılımcı veya gizli ham veri girmez; rolle ilişki, belge referansı, sürüm ve Claim için gerekli redakte edilmiş metin bölümü yeterlidir. Erişim ve saklama, ekip tarafından kullanım durumuna göre düzenlenir.
2. İddiaları atomize et: Her ifade ayrı bir Claim-ID alır. Öneriler, olgular, değer yargıları ve belirsizlikler ayrılır.
3. Kaynağı belirle: Her ifade için uygun, onaylanmış kaynak aranır. Sürüm durumu ve geçerlilik kapsamı denetlenir.
4. Desteği değerlendir: Kaynak somut Claim'i taşımalı, onunla çelişmeli veya soruyu açık bırakmalıdır. Salt konu bağlantısı yeterli değildir.
5. Bağımsız karşı okuma yap: Uzman kişi Claim'i ve kanıtı denetler; sonuçları ağır kararlar için yalnızca ilk yapay zekâ metnini tekrar etmeyen bir merciye danışılır.
6. Düzelt ve geri bildir: Yanlış veya aşırı ifade, sınırlı bir bilgiyle değiştirilir. Ekip, kullanım durumuna, zararın niteliğine ve yürürlükteki yükümlülüklere göre etkilenen kişilerin önceki yanlış bilgi hakkında bilgilendirilip bilgilendirilmeyeceğini ve nasıl bilgilendirileceğini inceler.
7. Tekrarı denetle: Ekip, sonraki çalıştırmada kaynağın doğru kullanılıp kullanılmadığını test eder ve sapmaları kaydeder. Tek bir başarılı tekrar kalıcı hatasızlığı kanıtlamaz.
Sisteme kendi yanıtını incelemesini istemek yararlı bir testtir. Sonuç örneğin atıf yapılan bir sürüm veya alternatif yorum için ipucu verebilir. Ancak bağımsız bir denetim adımı değildir. Sistem aynı yanlış ön koşulu tekrar kullanırsa, kendi iddiasını bağımsız bir kaynakla doğrulamamıştır. Tersine, kendi fark ettiği bir belirsizlik, Claim'i durdurmak ve bir kişiyi dahil etmek için neden olabilir. [9]
Böylece F-D, ilk sonucun statüsünü değiştirir. Ekip “Python zorunludur” yönündeki aceleci ifadeyi reddeder ve onun yerine şunu formüle eder: “Onaylanmış temel program Python ön koşulu belirtmiyor. Ek belge, isteğe bağlı ileri düzey uygulama için Python kullanıyor. Başka bir kurs turu hakkında bilgi vermek için güncel sürüm incelenmelidir.” Bu yanıt daha az dramatiktir; ancak daha kesin sınırlandırılmıştır ve eyleme elverişlidir.
C – sağlam bir son soru ve çalışma planı
F-C, son soruyu ancak B ve D'den sonra bir araya getirir:
“Ön koşullar ve ileri düzey uygulamalara ilişkin hangi ifadeler onaylanmış kurs sürümünde kanıtlanmıştır; hangileri başka bir sürümden veya bir değer yargısından gelir ve bir sonraki katılım kararından önce yanlış bilgiyi nasıl düzeltiriz?”
Bir GROW adımı bunu kuruluş planına dönüştürebilir:
Goal: İlgilenen kişiler gereksiz teknik erişim engelleri olmadan doğru bilgi alır.
Reality: Temel program ve ek belge karıştırılmıştır; kaynak sürümü yanıtta görünür değildir.
Options: Yanıt elle hazırlanır, açıkça işaretlenmiş onaylanmış bir kaynaktan taslak oluşturulur veya belirsiz vakalarda sorumlu bir kişiye yönlendirilir.
Way forward: Bir sonraki kullanımdan önce ekip güncel bir kaynak listesi, sorumlu rol, durdurma vakası ve düzeltme protokolü belirler.
GROW burada bir sonraki eylem adımını yapılandırır. Ne bilginin doğruluğunu ne de seçilen yöntemin etkinliğini kanıtlar.
7. Küçük ekipler için bir inceleme yolu
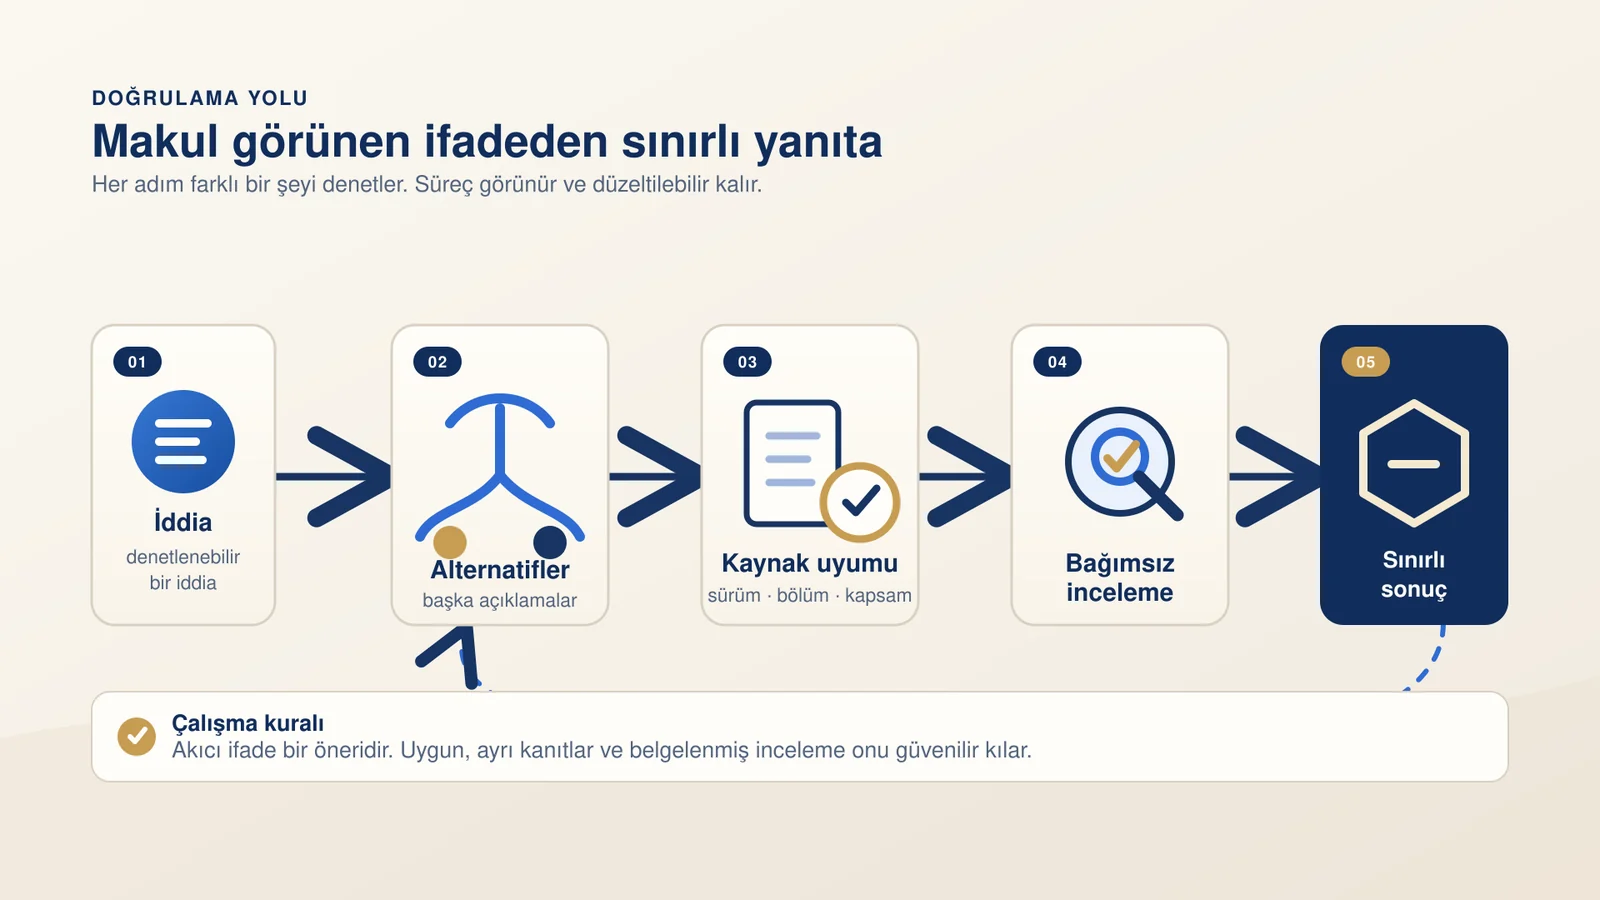
Küçük işletmelerin her bağlayıcı olmayan ifade için çok aşamalı bir audit'e ihtiyacı yoktur. Çabayı ve sonuçları izlenebilir bir orana getiren bir kurala ihtiyaçları vardır. Aşağıdaki yöntem editoryal olarak geliştirilmiş bir çalışma aracıdır; doğrulanmış bir risk ölçeği veya hukuka uygunluk incelemesi değildir.
Adım 1: Kullanımı ve etkiyi tanımlayın
Yanıtın ne yapması gerektiğini not edin: taslak, arama, özet, öneri veya karar hazırlığı. Çıktıyı kimin okuyacağını, bundan kimin etkileneceğini ve bunun hangi eylemi daha olası kılacağını sorun. Aynı dilsel hata, kurum içi bir fikir derlemesinde veya bağlayıcı görünen müşteri bilgisinde aynı etkiye sahip değildir.
Adım 2: İnceleme ihtiyacını sonuçlara göre belirleyin
En az dört özelliği dikkate alın:
Olası zarar: İddia erişimi, parayı, güvenliği, hakları veya önemli bir fırsatı etkileyebilir mi?
Geri döndürülebilirlik: Yanlış bir karar kalıcı sonuç olmadan kolayca düzeltilebilir mi?
Etkilenme: İnsanlar çıktıya itiraz edebilir, başka bir bilgi alabilir veya kullanımı reddedebilir mi?
Kanıta erişim: Güncel, yetkili bir kaynak ve onu mesleki olarak denetleyebilecek bir kişi var mı?
Olası sonuçlar ağır veya geri döndürülmesi zorsa, yüzeysel bir makullük incelemesi yeterli değildir. Uygun bir kaynak yoksa, doğru eylem çoğu zaman yanıtlamamak veya yönlendirmektir. “Yapay zekâ hiçbir şey bulmadı”, bir bilginin yanlış olduğu veya güvenle kabul edilebileceği anlamına gelmez.
Adım 3: İddiayı kaynakla karşılaştırın
İfade ifade karşılaştırın. Şunu sorun: Kaynak Claim'in tamamını, yalnızca bir bölümünü mü destekliyor, yoksa hiç mi desteklemiyor? Geçerlilik kapsamı uygun mu? Kaynak güncel ve yetkili mi? Başka geçerli bir sürüm çelişiyor mu? Değer yargısı olgu olarak mı sunuluyor? Bu sorular retrieval kullanan RAG sistemlerine de retrieval olmadan kullanılan bir chat'e de uygulanabilir.
Adım 4: Sorumlu bir handoff belirleyin
Net bir rol dağılımı küçük olabilir: Bir kişi kullanım durumundan sorumludur, uzman bir rol kaynakları denetler ve yetkili bir onay rolü kullanım veya durdurma hakkında karar verir. Küçük bir işletmede aynı kişiler birden çok rol üstlenebilir; yine de inceleme adımlarını görünür biçimde ayırmaları gerekir. “Döngüde insan” ancak kişinin zamanı, bilgisi, erişimi ve gerçek müdahale yetkileri varsa yardımcı olur.
Adım 5: Düzeltmeyi ve öğrenmeyi mümkün kılın
Hata türlerini, etkilenen Claim'leri, bulunan kaynak boşluklarını ve düzeltmeleri kaydedin. Belirli belgelerin eski, çelişkili veya bulunması zor olup olmadığını gözlemleyin. Örgütsel neden belirsiz onaylarda, kötü yönetilen bir bilgi tabanında veya uygunsuz görev dağılımında olabilir. Bir model hatası otomatik olarak yalnızca model sorunu değildir.
Gönüllü NIST profili kaynakları ve alıntıları denetlemeyi, testleri uygunsuz biçimde genellememeyi ve riskleri işletim boyunca gözlemlemeyi önerir. Küçük ekipler için buradan net sorumluluğu, durdurma yolu ve düzeltme protokolü olan orantılı bir uygulama türetilebilir; somut düzenleme kullanım durumuna bağlı kalır. [10]
8. En güçlü karşı görüş: İnceleme zaman alır
Bir ekip, her yapay zekâ çıktısı için tam kanıt incelemesinin çok pahalı olacağına haklı olarak itiraz edebilir. Yapay zekâ yalnızca başlıkları sıralıyor veya kurum içi bir taslağı dilsel olarak kısaltıyorsa, kapsamlı bir onay süreci olası hatadan daha fazla maliyet yaratabilir. İnceleme kapasitesi sınırlıdır. Her görevi aynı ele alan kişi çalışanları zorlar ve yararlı uygulamaları engelleyebilir.
Onaylanmış bir kaynak da genel bir doğruluk sertifikası değildir: Bir katılım ön koşulu için belirleyici, etki öngörüsü, değer çatışması veya teknik bir olgu için yetersiz olabilir. Bu nedenle Ledger, kaynak, Claim, sürüm ve geçerlilik kapsamının birbirine uyup uymadığını inceler; çözülmemiş kaynak çatışmaları açık kalır.
Bu itiraz önemli bir noktaya değinir. Sorumlu inceleme, her yanıtı her kullanımdan önce elle kelime kelime onaylamak anlamına gelmez. Amacı ve sonuçları bilmek, uygun inceleme derinliğini belirlemek ve belirsizlik için güvenli bir prosedüre sahip olmak demektir. Riski düşük, geri döndürülebilir bir asistans, açık işaretlemeyle ve örneklemeyle işletilebilir. Erişime veya güvenliğe dokunan bir ifade daha güçlü bir kanıt ve onay zinciri gerektirir. Bulunamayan veya denetlenemeyen bir kaynak yanıtın sınırını tetiklemelidir.
Teknik önlemler yardımcı olabilir: Onaylanmış belgelerde arama, sürüm metadata'sı, eksik kaynaklara ilişkin uyarılar ve örneklemeye dayalı testler. Hiçbir önlem tek başına doğruluğu kanıtlamaz. Bir bağlantı yanlış bölümü gösterebilir; bir detektör sistematik hataları gözden kaçırabilir; bir inceleme zaman baskısı altında başarısız olabilir. Birleşim göreve, verilere, modele, kullanıcı grubuna ve hata toleransına bağlıdır.
İnceleme maliyetlerine uygun yanıt, açık eşiklerle seçici incelemedir. Kolay düzeltilebilir taslaklarda çaba düşük kalabilir. Bir ifade erişimi veya geri döndürülmesi zor bir kararı biçimlendirdiğinde daha güçlü kanıt ve etkili gözetim gerekir.
9. Kurs alıştırması: iddia, kanıt, hüküm
Bu 60 ila 75 dakikalık alıştırma küçük bir öğrenme grubu veya KOBİ ekibi için tasarlanmıştır. Gerçek katılımcı verilerine ihtiyaç duymaz. Bu makaledeki kurgusal kurs vakası yeterlidir.
Öğrenme hedefleri
Alıştırmadan sonra öğrenenler şunları yapabilir:
1. üretilmiş bir yanıtı en az üç ayrı ayrı denetlenebilir Claim'e ayırmak; 2. her ifade için uygun kaynak, inceleme yöntemi ve geçerlilik kapsamı belirtmek; 3. F-B ile en az iki alternatif açıklama ve ayırt edici kanıt belirtmek; 4. erken bir yanıtı, yapay zekâ tekrarını bağımsız doğrulama saymadan F-D üzerinden düzeltmek; 5. sorumlu bir rol, bir durdurma vakası ve bir yeniden inceleme koşulu formüle etmek.
Akış
1. İlk yanıtı okuyun (5 dakika). Bir kişi yanıttaki tüm olgusal iddiaları, değer yargılarını ve eylem tavsiyelerini işaretler.
2. Claim'leri ayırın (10 dakika). Ekip, ifade, gereken kaynak ve geçici statü içeren bir Claim-Ledger tamamlar. Her kişi tam olarak neyin incelendiğini anlayabilmelidir.
3. F-B ile alternatifler oluşturun (10 dakika). Küçük gruplar iki veya daha fazla açıklama oluşturur. Yalnızca varsayımları değil, bunları birbirinden ayıracak gözlemi de belirtirler.
4. Kaynağı inceleyin (15 dakika). Kurs yürütücüsü üç kurgusal belge dağıtır: onaylanmış temel program, eski bir program belgesi ve isteğe bağlı Python ek belgesi. Grup sürümü, geçerlilik kapsamını ve kesin bölümü belirler. Hiçbir kaynak, gerçekte söylediğinden daha fazlası için kullanılmaz.
5. F-D döngüsünü uygulayın (10 dakika). Ekip önce beklenen sonucu, karşı kanıtı, düzeltmeyi ve açık kalanları kaydeder. Yeniden bir model yanıtı teşhis ipucu olarak kullanılabilir; incelenmiş kanıt ve onun belgelenmiş değerlendirmesi kanıt yolunu oluşturur.
6. Uygulama kuralına karar verin (10 dakika). Grup bilgiyi kimin onaylayacağını, ne zaman durduracağını, düzeltmenin nasıl iletileceğini ve hangi değişikliğin yeniden inceleme başlatacağını belirler.
7. Peer Review (10–15 dakika). Başka bir ekip her olgusal iddianın belirtilen bölüm tarafından gerçekten desteklenip desteklenmediğini ve bir değer yargısının olgusal bilgi gibi görünüp görünmediğini denetler.
Değerlendirme ızgarası
| Ölçüt | Şu durumda karşılanır… |
|---|---|
| Claim netliği | İncelenen her ifade komşu cümlelerden bağımsız okunabilir. |
| Kaynak uygunluğu | Kaynak, sürüm, bulgu yeri ve geçerlilik kapsamı anlaşılırdır. |
| Alternatifler | En az iki olası açıklama ayırt edici kanıtla ilişkilendirilir. |
| Düzeltilebilirlik | İlk ifade sessizce üzerine yazılmaz; hata, düzeltme ve açık noktalar izlenebilir kalır. |
| Sorumluluk | Bir rol durdurabilir, diğeri inceleyebilir veya kararı eskale edebilir. |
| Etkilenenlerin perspektifi | Grup, yanlış bilginin erişimi veya eylem olanaklarını nasıl etkilediğini sorar. |
Değerlendirme, bu alıştırmadaki gerekçelendirme kalitesini ölçer. Belirli bir prompt'un, soru modelinin veya yapay zekâ ürününün genel olarak etkili olduğunu kanıtlamaz.
10. Danışma veya uzman incelemesinin eklendiği durumlar
F, bu makalede soru ve kanıtla ilişki üzerinde yoğunlaşır. Üretilmiş bir bilgi gerçek hayatta kullanılacaksa, danışma modeli K analizi etkilenen roller, değerler, governance ve geri bildirimle genişletir: Yanlış bir kurs ön koşulundan kim etkilenir, onaylanmış kaynağı kim güncel tutar ve şikâyetler nasıl geri akar?
Model sırası Almanca SAKIZLI şablonlarını izler: Soru modeli F v5 (A → B → D → C), dört aşamalı çekirdek döngüsü ve beş aşamalı vaka senaryosu adımlarıyla danışma modeli K ile ayrı beş aşamalı danışmanlık modeli R. Bu adlar ve aşamalar şablonları tanımlar; buradaki uygulama didaktik bir aktarımdır, haricî bir etkililik doğrulaması değildir.
Danışma modelinin çekirdek döngüsü Keşif, Yansıtma ve Analiz, Karar ve Öneri, Geri Bildirim ve Değerlendirme'dir. Vaka bir pilot çalışma gerektirirse, uygulama ve sonuç değerlendirmesi ek senaryo adımları olarak ayrıntılandırılabilir. Bu daha uzun vaka sırası, ayrı beş aşamalı danışmanlık modeli R ile bir tutulamaz. K, governance ve öğrenmeyi taşır; R sözleşme, hukuk, düzenleme veya teknik due diligence söz konusu olduğunda somut bir uzman inceleme sorusunu üstlenir. Hiçbir model uzman incelemesinin yerini almaz veya kendi etkinliğini kanıtlamaz.
Bu makale için küçük bir K geçişi şöyle görünebilir:
| K-adımı | Vakadaki somut soru |
|---|---|
| Keşif | Fiilen hangi bilgi kullanılıyor, hangi kaynaklar onaylı ve bir hatadan kim etkilenir? |
| Yansıtma ve Analiz | Hangi Claim'ler ampirik, hangileri değer yüklü ve hangi karşı görüş veya etkilenen perspektifi eksik? |
| Karar ve Öneri | Asistan taslaklarla mı sınırlı kalır, dar kapsamlı soruları yanıtlayabilir mi yoksa yönlendirmesi mi gerekir? |
| Geri Bildirim ve Değerlendirme | Yanlış yanıtlar nasıl bildirilir, düzeltilir ve kurs belgelerinde bir değişiklikten sonra yeniden incelenir? |
Bir soru gerçek sözleşme koşullarını veya yasal katılım ön koşullarını ilgilendiriyorsa, bu örnekten hukuki bilgi oluşturulmaz. Ekip; bağlam, sürüm, hukuk alanı ve gereken kanıtla birlikte kesin bir uzman inceleme görevini nitelikli bir mercie aktarır. R bu aktarımı düzenler; yapay zekâ tarafından genel bir hukuki onay yoktur.
11. Yayımlama veya karar öncesinde pratik kontrol listesi
☐ Çıktı tekil, denetlenebilir Claim'lere ayrıldı.
☐ Olgusal iddialar, değer yargıları, öngörüler ve öneriler işaretlendi.
☐ Her Claim için güncel, yetkili bir kaynak veya açık bir sonuç kaydedildi.
☐ Sürüm durumu, geçerlilik kapsamı ve kesin bulgu yeri incelendi.
☐ İddia ve kaynak doğrudan karşılaştırıldı; yalnızca bir alıntı veya bağlantı inceleme sayılmaz.
☐ En az bir rakip açıklama ve ayırt edici kanıt not edildi.
☐ Temelsiz ifade düzeltildi, sınırlandırıldı veya geri tutuldu; zımnen ekleme yapılmadı.
☐ Etkilenen kişiler üzerindeki etkiler ve olası dışlamalar değerlendirildi.
☐ İnceleme rolü ve onay rolü belirlendi; durdurma ve eskalasyon yolu pratikte erişilebilir.
☐ Daha önce iletilmiş yanlış bilgilerin düzeltilmesi için yol belirlendi.
☐ Bir testin sınırları ve açık belirsizlik açıkça belirtildi.
☐ Yalnızca gerçek uzmanlık ihtiyacı olduğunda hukuk, düzenleme veya sözleşme için nitelikli danışmanlığa aktarıldı.
Liste, her riskin bulunacağını veya yürürlükteki bir düzenlemenin karşılanacağını garanti etmez; öğrenme ve çalışma şablonudur. Değeri, somut bir gerekçelendirme yolunu görünür kılmasındadır.
12. Bu makaleden çıkan sonuç
Tutarlı bir yanıt taslak olarak yararlı olabilir. Arama terimleri sağlayabilir, belgeleri düzenleyebilir, farkları işaretleyebilir ve bir tartışma başlatabilir. Ancak ileri sürdüğü şeyin incelenmesinin yerini almaz. Belirleyici sınır, dilsel performans ile izlenebilir destek arasındadır.
Soru modeli bu sınırı pratikte ele almaya yardımcı olur. F-A, söz konusu Claim'i ve kaynağı açıklar. F-B ilk makul yanıtı doğrulamak yerine rakip açıklamaları açar. F-D eksik kanıtı ve düzeltmeyi görünür kılar. Ancak bundan sonra F-C sınırlı bir son soru ve çalışma planı formüle eder. K, bilgi sorusu etkilenen kişiler ve kurallarla birlikte bir kuruluş kararına dönüştüğünde devreye girer. R yalnızca kesin bir uzman inceleme görevi için eklenir.
Küçük bir ekip için bu, her yapay zekâ çıktısına güvenmemek anlamına gelmez. Kanıt standardını olası etkiye göre ayarlamak, kaynakları gerçekten okumak ve düzeltme yolunu kullanımdan önce belirlemek anlamına gelir. Bir ifade kanıtlanmamışsa açık kalabilir. Belirleyici bir kaynakla çelişiyorsa düzeltilmelidir. Sonuçlar ağırsa yanıt vermemek savunulabilir bir karardır.
Bir sonraki yapay zekâ taslağı için yol gösterici soru şudur: “Hangi tekil ifadeyi yapmak istiyorsun, bu soru için belirleyici hangi kanıt onu destekliyor ve onu ne zaman gözden geçirmemiz gerektiğini nasıl anlayacağız?”
Kaynaklar
1. Brown, T. B. et al. (2020). “Language Models are Few-Shot Learners.” Advances in Neural Information Processing Systems 33, 1877–1901; arXiv:2005.14165. https://doi.org/10.48550/arXiv.2005.14165. Otoregresif dil modellerinin dar kapsamlı teknik bağlamı için kullanılmıştır.
2. Peirce, C. S. (1877). “The Fixation of Belief.” Popular Science Monthly, 12, 1–15. Özgün metin: https://www.peirce.org/writings/p107.html. Kamusal olarak denetlenebilir araştırma ve düzeltilebilir inançlar üzerine felsefi perspektif olarak kullanılmıştır; hazır bir yapay zekâ inceleme prosedürü olarak değil.
3. Maynez, J., Narayan, S., Bohnet, B. & McDonald, R. (2020). “On Faithfulness and Factuality in Abstractive Summarization.” Proceedings of ACL 2020, 1906–1919. https://doi.org/10.18653/v1/2020.acl-main.173. Görev ve test edilen sistemler aktarılabilirliği sınırlar.
4. Lin, S., Hilton, J. & Evans, O. (2022). “TruthfulQA: Measuring How Models Mimic Human Falsehoods.” Proceedings of ACL 2022, 3214–3252. https://doi.org/10.18653/v1/2022.acl-long.229. Metindeki sayılar yalnızca benchmark'a ve o sırada test edilen model kümesine ilişkindir.
5. Rashkin, H. et al. (2023). “Measuring Attribution in Natural Language Generation Models.” Computational Linguistics, 49(4), 777–840. https://doi.org/10.1162/coli_a_00486. AIS, otomatik doğruluk garantisi olarak değil, değerlendirme yaklaşımı olarak açıklanmıştır.
6. Niu, C. et al. (2024). “RAGTruth: A Hallucination Corpus for Developing Trustworthy Retrieval-Augmented Language Models.” Proceedings of ACL 2024, 10862–10878. https://doi.org/10.18653/v1/2024.acl-long.585. İncelenen RAG çıktılarındaki hata vakalarını kanıtlar; retrieval'ın genel etkisizliğini değil.
7. Jiang, Z., Araki, J., Ding, H. & Neubig, G. (2021). “How Can We Know When Language Models Know? On the Calibration of Language Models for Question Answering.” Transactions of the Association for Computational Linguistics, 9, 962–977. https://doi.org/10.1162/tacl_a_00407. Sonuçlar o dönemin modellerine ve QA görevlerine ilişkindir.
8. Farquhar, S. et al. (2024). “Detecting Hallucinations in Large Language Models Using Semantic Entropy.” Nature, 630, 625–630. https://doi.org/10.1038/s41586-024-07421-0. Sınırlı bir hata türünü tespit eder; yaklaşım olgusallığı garanti etmez.
9. Huang, J. et al. (2024). “Large Language Models Cannot Self-Correct Reasoning Yet.” International Conference on Learning Representations 2024. https://proceedings.iclr.cc/paper_files/paper/2024/hash/8b4add8b0aa8749d80a34ca5d941c355-Abstract-Conference.html. İncelenen reasoning görevlerinde dış geri bildirim olmadan içsel düzeltmeye ilişkin bulgu.
10. Autio, C. et al. (2024). Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. NIST AI 600-1. https://doi.org/10.6028/NIST.AI.600-1. Gönüllü, sektörler arası risk yönetimi kılavuzu; hukuk normu veya uygunluk belgesi değildir.
Konumlandırma notu: Makale, birincil araştırmayı, gönüllü bir risk yönetimi profilini ve felsefi bir birincil metni birleştirir. Vaka çalışması, kontrol listesi ve Claim-Ledger editoryal olarak geliştirilmiş öğretim araçlarıdır. Bu metne dâhil edilmeleri bilimsel geçerlilik veya garantili hata önleme iddiasında bulunmaz.
0 yorum
● Yorumlar yükleniyor…