Chunking, parsing ve kaybolan bağlantılar
Chunk yalnız text parçası değildir. Provenance, neighbourhood ve document içindeki role sahip bir meaning unit'tir.
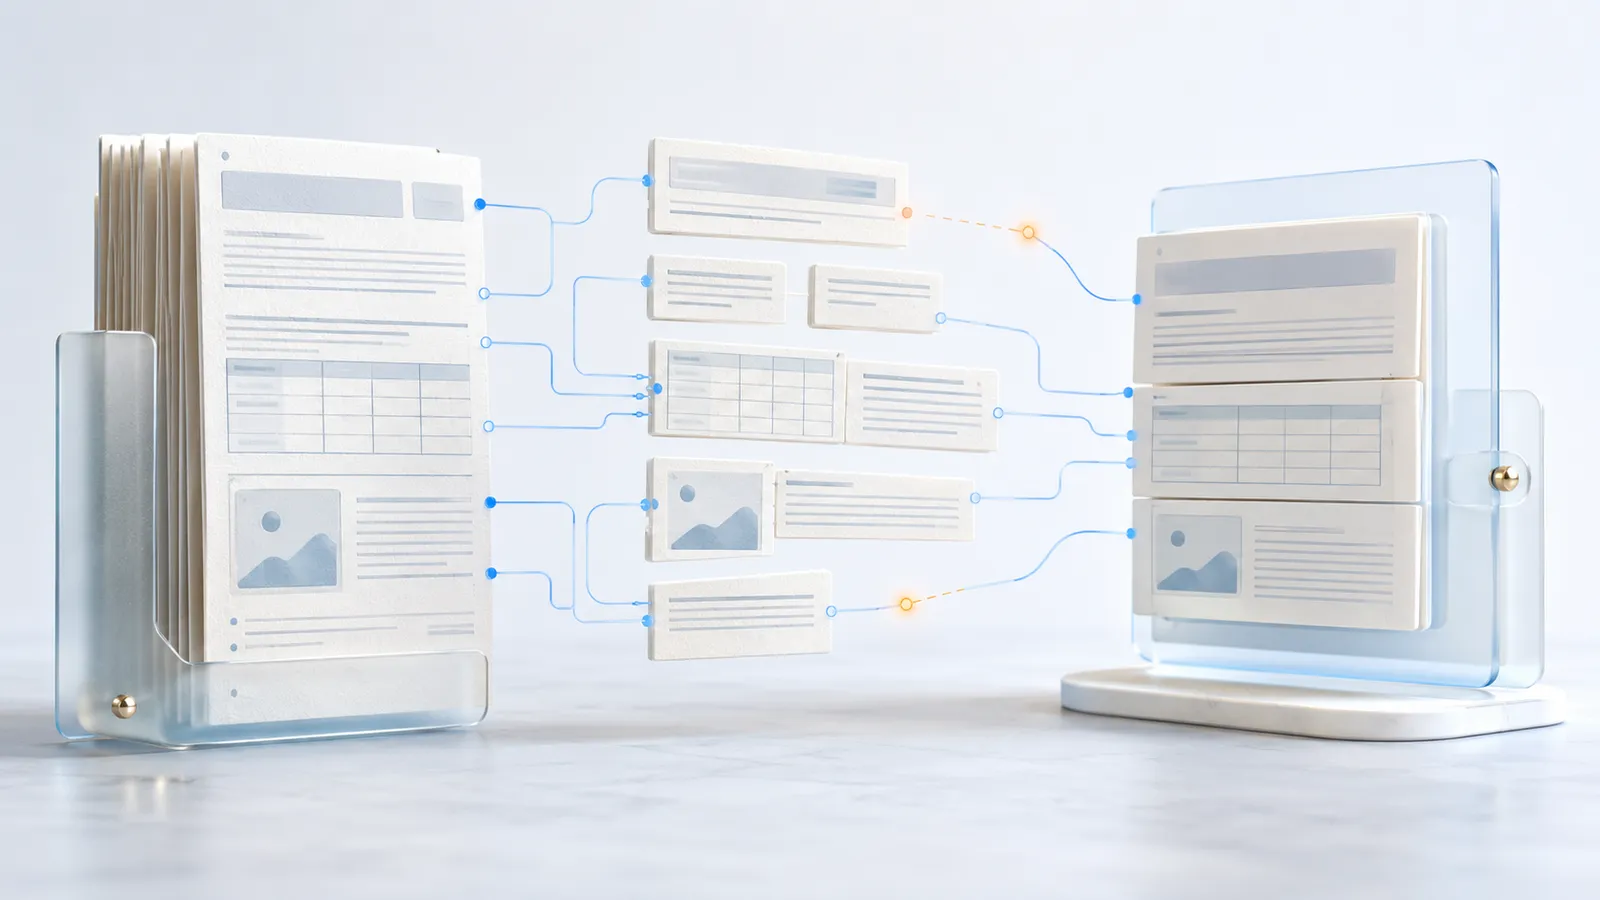
Retrieval system çoğunlukla complete document üzerinde çalışmaz. Content daha küçük unit'lere ayrılır, representation oluşturulur ve sonra relevant segment aranır. Süreç mekanik görünür: text extract et, sabit length ile kes, embedding oluştur. Fakat daha sonra language model'e yüklenen birçok hata burada doğar.
Table row header olmadan, exception bağlı olduğu rule olmadan veya caption figure olmadan retrieve edilirse result semantically damaged olur. Benzer word taşısa bile aynı claim'i ifade etmeyebilir. Chunking storage optimisation değildir; system'in hangi knowledge unit'i görebileceğine, karşılaştırabileceğine ve cite edebileceğine karar verir.
Parsing chunking'den önce gelir
PDF önce page üzerindeki character ve graphic element düzenidir. Visual order otomatik olarak machine-readable reading order değildir. Column, header, footer, page number, footnote, callout, table ve scan basit extraction sırasında karışabilir.
Parsing layout'tan document structure'ı yeniden kurar. Heading level, paragraph, list, table, figure, caption, footnote ve page reference tanınır. Scan için OCR gerekir. Ancak bu reconstruction'dan sonra hangi parçaların birlikte kalması gerektiği belirlenebilir.
Parser da fail olabilir: footer tekrar eden paragraph olur, iki column iç içe geçer, hyphen yanlış çözülür veya table ilişkisiz word sequence'e dönüşür. Parser yalnız plain text değil; type, position, reading order ve confidence içeren structured element vermelidir. Docling layout analysis ve table structure recognition ile bu yaklaşımı açıklar. Tool değişebilir, architecture principle değişmez.
Document aynı anda birkaç order taşır
Document linear order, hierarchical organisation ve reference relation taşır. Paragraph diğerini izler, heading altında bulunur ve üç page sonraki table'a referans verebilir. Plain text yalnız linear sequence'i korur.
Reliable retrieval ayrıca şu path'i ister: document → chapter → section → element. Neighbour, cross-reference ve source version da buna eklenir. „Aşağıdaki exception'lar uygulanır" heading ve predecessor olmadan anlamsızdır. Security policy → Access control → External accounts → Exceptions path'i scope'u görünür yapar.
Fixed window baseline'dır, strategy değil
En basit segmentation sabit token veya character sayısında keser. Hızlı ve reproducible'dır; fakat sentence, paragraph ve section boundary'lerini bilmez. Kesim tam rule ile condition arasına düşebilir.
Small chunk topic precision'ı artırabilir, fakat definition, qualification ve rationale kaybolur. Large chunk daha fazla context korur; buna karşılık topic'leri karıştırır, context budget tüketir ve relevant passage'ı seyreltir. Universal doğru size yoktur. Glossary entry, contract clause, table row ve method chapter farklı segmentation profile ister.
Overlap bir segment'in bölümünü sonrakinde tekrarlar. Kısa argument için yararlıdır, fakat duplicate yaratır ve structure'ı geri kurmaz. Yüz token tekrarı table row'a doğru column header'ı garanti etmez. Footnote reference anchor olmadan ambiguous kalır. Overlap local safety margin'dir; explicit relation yerine geçmez.
Table küçük bir data model'dir
Cell meaning'i row ve column header, unit, grouping ve çoğu zaman footnote'tan gelir. Yalnız „12 | 18 | 24" içeren segment bunların month, percentage veya quantity olduğunu göstermez. Useful table segment title, relevant header, unit, row label, value, footnote ve source location içerir.
Large table row group'lara ayrılabilir; her child full table'ı temsil eden parent'a link vermelidir. Trend question için structured data representation text'ten daha uygun olabilir. Caption, figure ID ve explanatory paragraph da ayrı saklansa bile linked kalır.
Cross-reference hidden dependency yaratır
„Yukarıda açıklandığı gibi", „bu değerler" veya „şuna uygulanmaz" başka yere işaret eder. Segment grammatical olarak complete görünürken referent kaybolmuş olabilir. Context packet küçük primary chunk, section path, kısa parent summary ve selectively resolved reference içerebilir.
Parent-child model search ile answer granularity'yi ayırır. Small child kolay retrieve edilir; hit geldiğinde larger parent veya defined neighbourhood kontrollü biçimde yüklenir. Bu bütün chunk'ları baştan büyük yapmaktan daha robust olabilir.
Semantic ve hierarchical method
Semantic chunking topic değiştiğinde boundary koyar. Prose'da rigid window'dan daha iyi olabilir, ancak formal relation'ı her zaman tanımaz. Robust strategy hard structural boundary ile soft semantic signal'ı birleştirir.
Late Chunking önce broader context'i işler, sonra subregion için representation üretir. Böylece chunk embedding surrounding text'ten bilgi taşıyabilir. Bu promising bir method'dur, universal repair değildir: broken reading order, table structure veya missing version düzelmez.
RAPTOR content'i recursively summarise eder ve tree içinde organize ederek farklı abstraction level'larda retrieval sağlar. Detail segment ve higher-level synthesis birlikte indexlenebilir, fakat farklı evidence type olarak kalır. Summary primary source değildir; final claim underlying passage'a dönmelidir.
Large context window da problemi kaldırmaz. „Lost in the Middle" araştırması relevant information'ın long input içindeki position'a göre daha zayıf kullanılabildiğini gösterir. More context otomatik olarak better context değildir. Selection, ordering ve emphasis engineering task olarak kalır.
Çıkarım, anlama değildir
İlk işleme adımı içeriği teknik olarak erişilebilir kılar. Dijital PDF'den metin alınabilir; tarama için optik karakter tanıma gerekir. Tablo, sütun, dipnot, başlık ve okuma sırası korunmalı ya da yeniden kurulmalıdır. Akıcı görünen metin, belge yapısının doğru yakalandığını kanıtlamaz.
Kalite bu nedenle sınanabilir çıkarım özellikleriyle başlar: sayfa bağlantısı, algılanan belge türü, dil, OCR güveni, tablo sayısı ve okunamayan alan uyarıları. Kritik kaynaklarda çıkarılan metin görsel özgün sayfaya geri bağlanmalıdır. Böylece hata yanıttan bölüme, oradan taramaya kadar izlenebilir.
● Yalnızca üyeler
Üyelikle tüm makaleyi oku ve tüm dosyaları indir.
Tüm makaleyi + indirmeleri aç → Abone ol0 yorum
● Yorumlar yükleniyor…