Kohärenz ist keine Wahrheit
Warum flüssige KI-Antworten Belege brauchen
Eine Antwort kann ruhig klingen, sauber gegliedert sein und genau die Begriffe verwenden, die ein Team erwartet. Trotzdem kann sie eine Voraussetzung erfinden, zwei Dokumentversionen vermischen oder eine unbelegte Schlussfolgerung als feststehende Information ausgeben. Für Organisationen lautet die entscheidende Frage deshalb nicht nur: „Klingt das plausibel?“ Sie lautet: Welche einzelne Behauptung wird durch welche für die konkrete Frage passende, vom Modelltext unabhängige Evidenz gestützt, und wer darf auf dieser Grundlage handeln?
Dieser Artikel erklärt, warum sprachliche Kohärenz und sachliche Richtigkeit verschiedene Eigenschaften sind. Er verbindet philosophische Fragen nach Wahrheit und Begründung mit Forschung zu faktischen Fehlern, Quellenbindung, Retrieval und Selbstkorrektur. Ein vollständig fiktiver Kursanbieter-Fall führt das Fragenmodell durch die Schritte A → B → D → C. Daraus entsteht ein Claim-Ledger, das kleine Unternehmen und Kursteams für begrenzte, überprüfbare KI-Anwendungen anpassen können.
Kernaussage: Eine entscheidungstragende Sachbehauptung wird nicht dadurch begründet, dass sie elegant formuliert, wiederholt, mit einem Link versehen oder bloß von einem zweiten Modell bestätigt wird. Erforderlich ist ein nachvollziehbarer Abgleich mit einer für die konkrete Frage maßgeblichen, vom Modelloutput getrennten Quelle. Für Werturteile, Prognosen und kausale Erklärungen braucht es jeweils eine passende Begründungs- und Prüfmethodik.
Für wen: Teams in kleinen und mittleren Unternehmen, Kursleitungen, Verantwortliche für KI-Einsatz und Lernende, die generierte Informationen fachlich prüfen müssen.
Lerngewinn: Nach der Lektüre können Sie eine Antwort in prüfbare Einzelbehauptungen zerlegen, konkurrierende Erklärungen formulieren, Belege nach Geltungsbereich bewerten und eine Korrektur so dokumentieren, dass eine andere Person sie nachvollziehen kann.
1. Der Moment, in dem eine plausible Antwort zum Risiko wird
Ein fiktiver kleiner Weiterbildungsträger lässt einen KI-Assistenten Fragen zum eigenen Kursprogramm beantworten. Die Anfrage lautet: „Welche Vorkenntnisse brauche ich für den Grundlagenkurs?“ Der Assistent antwortet in überzeugendem Ton: „Für Modul zwei sind Python-Kenntnisse zwingend. Ohne Programmiererfahrung ist eine Teilnahme nicht sinnvoll.“ Die Antwort klingt nachvollziehbar. Sie verwendet einen technischen Begriff, ordnet ihn einem Modul zu und empfiehlt eine klare Handlung.
Die offiziellen Unterlagen erzählen eine andere Geschichte. Das freigegebene Programm erklärt, dass keine Programmiererfahrung vorausgesetzt wird. Ein optionales Zusatzblatt für einen fortgeschrittenen Übungsblock empfiehlt Python-Erfahrung, macht sie aber nicht zur Bedingung für den Grundlagenkurs. Der Assistent hat zwei Aussagen zusammengezogen und eine Empfehlung in eine Zugangsvoraussetzung verwandelt.
Der Fehler ist keine abstrakte Kuriosität. Eine falsche Auskunft kann Menschen von einem Angebot fernhalten oder unnötige Vorbereitung auslösen. In anderen Einsatzgebieten könnte eine ähnliche Antwort Beschaffung, Wartung oder Kundenkommunikation beeinflussen. Die moralische Frage entsteht auch dann, wenn ein Team flüssige Sprache für belastbare Auskunft hält.
Der Fall ist vollständig fiktiv und beschreibt weder einen realen Kurs noch ein bestimmtes System. Er soll eine Prüfsituation sichtbar machen: Ein Satz kann stimmig innerhalb einer Erzählung wirken, ohne von der maßgeblichen Quelle gedeckt zu sein.
Das praktische Risiko besteht aus mehreren Schritten: Eine plausible Formulierung zieht Aufmerksamkeit auf sich; die Behauptung wird nicht in prüfbare Teile zerlegt; ein Team übernimmt sie, weil die Antwort Sicherheit ausstrahlt; die betroffene Person trägt schließlich die Folge. Zwischen Modelltext und Wirkung liegen also Entscheidungen von Menschen und Organisationen. Das macht die Prüfung zu einer Governance-Aufgabe, nicht nur zu einer Frage besserer Prompts.
2. Kohärenz, Wahrheit und Begründung sind nicht dasselbe
Kohärenz beschreibt zunächst, ob Teile einer Aussage zusammenpassen: Die Sätze widersprechen sich nicht offensichtlich, eine Erklärung hat einen erkennbaren Aufbau, und der Schluss scheint zu den vorherigen Sätzen zu passen. Kohärenz hilft beim Verstehen. Sie ist aber kein Beweis dafür, dass eine Behauptung der Welt entspricht.
Wahrheit betrifft den Sachverhalt, auf den sich eine Behauptung richtet. Ob der Grundlagenkurs Programmiererfahrung voraussetzt, hängt hier nicht davon ab, wie überzeugend der Satz klingt. Maßgeblich sind die gültigen Kursunterlagen und die tatsächlich beschlossene Zugangsvoraussetzung. In anderen Fragen kann die Lage weniger eindeutig sein: Werte, Prognosen oder kausale Erklärungen verlangen mehr als das Auffinden eines einzelnen Dokuments.
Begründung fragt, warum eine Person eine Aussage für wahr halten darf. Dazu gehören Belege, die für genau diese Behauptung relevant sind, eine passende Methode, ein klarer Geltungsbereich und die Bereitschaft, die Aussage bei Gegenbelegen zu ändern. Ein Quellenlink ohne Prüfung begründet noch nichts. Er kann auf eine veraltete Fassung zeigen, nur einen Teil des Satzes stützen oder das Thema lediglich erwähnen.
Der Philosoph Charles S. Peirce beschreibt wissenschaftliche Untersuchung als einen öffentlichen Weg, Überzeugungen an etwas zu prüfen, das nicht allein von unserer Meinung abhängt. Sein Aufsatz The Fixation of Belief unterscheidet diese Suche nach korrigierbarer Erkenntnis von Verfahren, mit denen Menschen an einer Überzeugung festhalten. Für heutige KI-Arbeit ist daran kein fertiges Prüfverfahren abzulesen. Der Anschluss ist eine methodische Haltung: Begründungen müssen für andere sichtbar, angreifbar und korrigierbar sein. Ein Modell kann dabei helfen, Fragen zu formulieren. Es kann die gemeinsame Prüfung nicht ersetzen. [2]
Damit wird auch die ethische Dimension klarer. Wenn eine Organisation KI-Ausgaben als Auskunft nutzt, verteilt sie nicht nur Information. Sie verteilt Zugang, Aufmerksamkeit, Arbeit und Fehlerrisiken. Wer eine falsche Voraussetzung als „objektiv“ präsentiert, kann Lernende ausschließen oder Beschäftigte in die Lage bringen, eine nicht überprüfte Behauptung zu vertreten. Die Verantwortung liegt bei den Rollen, die Zweck, Quelle, Freigabe und Folgen bestimmen.
Ein hilfreicher Unterschied lautet daher: Eine Antwort ist ein Vorschlag für eine Behauptung; ein Beleg ist eine prüfbare Verbindung zwischen der Behauptung und einer für sie passenden Quelle. Eine Quelle kann für eine Regel maßgeblich und für eine Prognose unzureichend sein. Das ist eine redaktionelle Arbeitsregel, kein experimentell validierter Wahrheitsalgorithmus.
3. Warum ein Sprachmodell überzeugend formulieren kann, ohne den Sachverhalt zu prüfen
Generative Sprachmodelle erzeugen Text anhand gelernter Muster und des jeweiligen Kontexts. GPT-3 wird in der Originalstudie als autoregressives Sprachmodell beschrieben; Architektur und Training unterscheiden sich zwischen Systemen. [1] Daraus folgt als Arbeitsgrenze dieses Artikels: Textgenerierung ist nicht automatisch eine unabhängige Prüfung, ob ein Claim durch ein aktuelles Dokument oder einen externen Sachverhalt gestützt wird. Für diesen Abgleich sind Quellenattribution und Risikoprüfung relevant. [5, 10]
Das ist kein Vorwurf, dass ein Modell „lügt“. Der Begriff Halluzination ist verbreitet, kann aber menschliche Absichten nahelegen, die damit nicht belegt sind. NIST verwendet für das Risikophänomen auch den Begriff Konfabulation: Inhalte, die ein generatives System selbstbewusst präsentiert, obwohl sie fehlerhaft oder falsch sind. Dazu zählen auch Ausgaben, die von Eingaben oder bereitgestelltem Kontext abweichen oder früheren Aussagen im selben Kontext widersprechen. In diesem Artikel sprechen wir je nach Fall konkreter von einer falschen, unbelegten oder widersprüchlichen generierten Behauptung. [10]
Mindestens vier Situationen müssen auseinandergehalten werden:
1. Falsche Behauptung: Die Aussage widerspricht dem Sachverhalt, der mit geeigneten Mitteln geprüft wurde.
2. Unbelegte Behauptung: Die vorliegenden Unterlagen stützen sie nicht. Das beweist nicht automatisch, dass sie falsch ist; der Status bleibt offen.
3. Widerspruch zum bereitgestellten Material: Die Antwort passt nicht zu einer angegebenen Quelle oder zu anderen Teilen des Kontexts.
4. Unvollständige oder mehrdeutige Aussage: Die Quelle beantwortet die Frage nicht vollständig, oder mehrere plausible Lesarten bleiben bestehen.
Diese Kategorien sind keine universelle Taxonomie der Forschung. Sie sind ein praktisches Raster für das hier entwickelte Claim-Ledger. Ein Werturteil wie „Der Kurs sollte zugänglicher sein“ ist zudem nicht mit einer empirischen Behauptung wie „Vorkenntnisse sind vorgeschrieben“ gleichzusetzen. Das erste braucht eine normative Begründung und Beteiligung betroffener Perspektiven; das zweite braucht eine passende Sachquelle.
Ein weiterer Unterschied betrifft Flüssigkeit und Zuverlässigkeit. Dass die Antwort in Grammatik und Stil menschlich wirkt, sagt wenig darüber aus, ob ihre Details auf einer Quelle beruhen. Die GPT-3-Studie zeigte, dass ein großes autoregressives Sprachmodell Texte erzeugen konnte, die menschliche Beurteilende nur schwer von menschlich verfassten Nachrichtentexten unterschieden. Die Studie belegt eine Fähigkeit zur überzeugenden Textproduktion in ihrem Versuchsaufbau; sie weist nicht nach, dass solche Texte faktisch korrekt sind. [1]
4. Was die Forschung belegt – und was sie nicht belegt
Forschung zu generiertem Text untersucht verschiedene Aufgaben, Modelle und Fehlerbegriffe. Ergebnisse dürfen nicht als zeitlose Prozentzahl für jedes heutige System zusammengefasst werden. Sie zeigen aber, warum Organisationen Sprachqualität nicht mit Faktentreue gleichsetzen sollten.
4.1 Fehler in Zusammenfassungen
Maynez und Kolleginnen und Kollegen untersuchten 2020 abstraktive Dokumentzusammenfassungen mit menschlicher Bewertung. In den getesteten Systemen fanden sie substanzielle Mengen an Inhalten, die nicht treu zur Eingabedokumentation waren. Die Arbeit zeigt für die untersuchte Aufgabe, dass eine gut klingende Zusammenfassung zusätzliche oder veränderte Inhalte enthalten kann. Sie liefert keine Fehlerrate für alle heutigen Chatbots und keine allgemeine Aussage über jede Generierungsaufgabe. [3]
4.2 Wahrheitsfragen sind messbar, aber aufgabenabhängig
TruthfulQA wurde mit 817 Fragen aus 38 Kategorien aufgebaut, die verbreitete falsche Überzeugungen oder Missverständnisse ansprechen. Im getesteten Modellbestand von 2022 war das beste untersuchte Modell bei 58 Prozent der Fragen wahrheitsgemäß; die Vergleichsleistung von Menschen lag bei 94 Prozent. Diese Werte gehören zu genau diesem Benchmark und den damaligen Systemen. Sie sind keine Schätzung für ein heutiges Produkt und kein Urteil über die Wahrheit jeder einzelnen KI-Ausgabe. Der methodische Punkt ist enger: Wahrheitstreue kann eigene Prüfung verlangen und folgt nicht automatisch aus allgemeiner Sprachleistung. [4]
4.3 Eine Quelle im Kontext macht die Antwort noch nicht geerdet
Retrieval-Augmented Generation (RAG) sucht zunächst Material ab und gibt gefundene Inhalte als Kontext an ein Sprachmodell weiter. Das schafft eine wichtige Evidenzspur, beseitigt aber nicht alle Fehler. Der RAGTruth-Datensatz dokumentiert in seinen untersuchten RAG-Antworten weiterhin Aussagen, die durch abgerufene Inhalte nicht gedeckt werden oder ihnen widersprechen. Daraus folgt nicht, dass RAG insgesamt wirkungslos ist. Es folgt, dass „Quelle gefunden“ und „Behauptung durch diese Quelle gestützt“ zwei verschiedene Prüfschritte sind. [6]
4.4 Quellenangaben müssen inhaltlich geprüft werden
Das Attributable-to-Identified-Sources-Verfahren (AIS) von Rashkin und Kolleginnen und Kollegen macht die Verbindung zwischen einer generierten Aussage über die Außenwelt und einer unabhängig bereitgestellten Quelle zum Gegenstand der Bewertung. Das ist für Teams nützlich, weil es den Blick von der bloßen Existenz eines Zitats auf seine tatsächliche Stützung lenkt. AIS ist ein Evaluationsrahmen; es ist nicht automatisch ein Produkt, das jede Quelle zuverlässig prüft. [5]
4.5 Sicherheit im Ton ist keine kalibrierte Wahrscheinlichkeit
Eine Formulierung wie „ganz sicher“ klingt eindeutig. Ein tatsächlicher Konfidenzwert eines Modells ist eine andere, technische Größe. Kalibrierung fragt, ob angegebene Wahrscheinlichkeiten über viele vergleichbare Fälle mit beobachteter Richtigkeit übereinstimmen. Jiang und Kolleginnen und Kollegen fanden bei den damals untersuchten Frage-Antwort-Modellen T5, BART und GPT-2 deutliche Kalibrierungsprobleme und zeigten zugleich Verfahren zur Verbesserung. Das rechtfertigt keine pauschale Aussage über alle aktuellen Systeme. Es rechtfertigt aber, unkalibrierte Sicherheitssprache weder als Messwert noch als Beleg zu behandeln. [7]
Farquhar und Kolleginnen und Kollegen entwickelten 2024 semantische Entropie, um eine Teilmenge beliebiger und fehlerhafter Ausgaben, die sie als Konfabulationen beschreiben, zu erkennen. Der Ansatz kann zusätzliche Vorsicht oder eine gezieltere Suche auslösen. Die Autorinnen und Autoren grenzen ihn ausdrücklich ein: Er garantiert keine Faktizität und hilft nicht, wenn ein System systematisch falsch liegt. Ein Unsicherheitssignal ist somit ein Triagehinweis, kein Wahrheitszertifikat. [8]
4.6 Wiederholen und „noch einmal prüfen“ ist keine unabhängige Kontrolle
Wenn dieselbe KI ihre erste Antwort auf die Bitte „Kontrolliere dich noch einmal“ überprüft, entsteht nicht automatisch eine unabhängige Evidenzquelle. Huang und Kolleginnen und Kollegen untersuchten intrinsische Selbstkorrektur ohne externe Rückmeldung in Reasoning-Aufgaben. In den getesteten Bedingungen gelang eine zuverlässige Selbstkorrektur nicht; teilweise verschlechterte sie die Leistung. Daraus folgt nicht, dass jede Form von Selbstkorrektur nutzlos ist. Es folgt, dass ein weiterer Durchlauf ohne neue Evidenz keine unabhängige Bestätigung darstellt. [9]
Sprachmodelle können bei Suche, Strukturierung und Entwürfen helfen. Für entscheidungstragende Sachbehauptungen muss ein Team dennoch prüfen, ob Quelle, Aussage und Einsatzkontext zusammenpassen. Das freiwillige NIST-Profil empfiehlt Quellenprüfung, kontextgerechte Tests und betriebliche Fehlerbeobachtung; es ist weder Gesetz noch Fehlergarantie. [10]
5. Fallarbeit: von einem überzeugenden Satz zu prüfbaren Claims
Zurück zum fiktiven Weiterbildungsträger. Der Assistent hat einen Absatz mit drei Aussagen produziert:
„Für Modul zwei sind Python-Kenntnisse zwingend. Ohne Programmiererfahrung ist eine Teilnahme nicht sinnvoll. Die offizielle Kursbeschreibung bestätigt diese Voraussetzung.“
Die Sätze klingen wie eine einzige Auskunft. Für eine faire Prüfung zerlegt das Team sie:
| Claim | Aussage | Benötigte Evidenz | Vorläufiger Status |
|---|---|---|---|
| C1 | Python-Kenntnisse sind für Modul zwei zwingend. | Gültiges, freigegebenes Programm oder formell beschlossene Zulassungsregel. | WIDERSPROCHEN durch das freigegebene Grundlagenprogramm. |
| C2 | Ohne Programmiererfahrung ist Teilnahme nicht sinnvoll. | Lernziel- und Kursdesignbegründung; außerdem eine normative Entscheidung zur Zielgruppe. | UNBELEGT; Empfehlung wird nicht aus der Quelle übernommen. |
| C3 | Die offizielle Kursbeschreibung bestätigt die Voraussetzung. | Versions- und Abschnittsprüfung der offiziellen Kursbeschreibung. | FALSCH im fiktiven Fall; das Dokument sagt, dass keine Programmiererfahrung vorausgesetzt wird. |
| C4 | Ein fortgeschrittener Übungsblock nutzt Python. | Gültiges Zusatzblatt und sein Zielpublikum. | BELEGT, aber nicht gleichbedeutend mit einer Zugangsvoraussetzung. |
Die Tabelle trennt vier Fragen, die der Text zusammengeschoben hat. Besonders wichtig ist C2: „nicht sinnvoll“ ist nicht bloß eine Tatsachenfeststellung. Es kann eine Bewertung oder eine Zugangspolitik ausdrücken. Selbst wenn ein fortgeschrittener Übungsblock technische Vorkenntnisse erfordert, folgt daraus nicht, dass der gesamte Grundlagenkurs ungeeignet ist. Betroffene Lernende würden in der Entscheidungsrunde gehört, wenn das Team den Zugang tatsächlich neu gestalten wollte.
Der Fall enthält außerdem eine Versionsfrage. Die verantwortliche Person muss nicht irgendein PDF finden, sondern die gültige, freigegebene Quelle identifizieren. Eine Datei aus einem alten Kursdurchlauf, ein Entwurf und ein Zusatzblatt können alle echt sein und trotzdem unterschiedliche Fragen beantworten. Quellenprüfung verlangt daher mindestens: Dokumenttitel, Fassung, Gültigkeitsbereich, zuständige Freigabe und die Textstelle, die den Claim trägt.
Ein Beispiel für ein Claim-Ledger
| Claim-ID | Wortlaut | Quelle und Fundstelle | Prüfurteil | Grenze | Nächster Schritt |
|---|---|---|---|---|---|
| C1 | „Python ist zwingend.“ | Freigegebenes Grundlagenprogramm, Abschnitt „Voraussetzungen“ | Widersprochen | Gilt nur für die geprüfte Fassung und diesen Kurs. | Aussage korrigieren; neue Versionsänderung beobachten. |
| C2 | „Ohne Erfahrung ist der Kurs nicht sinnvoll.“ | Keine passende Sachquelle; im Assistententext ergänzt | Offen / Werturteil | Die Quelle kann die pädagogische Zweckmäßigkeit nicht allein entscheiden. | Zielgruppe und alternative Lernunterstützung konsultieren. |
| C3 | „Die offizielle Beschreibung bestätigt es.“ | Dieselbe offizielle Beschreibung, Abschnitt „Teilnahme“ | Falsch im Fall | Der Assistent benennt eine Stützung, die die Stelle nicht liefert. | Quellenangabe und Antwort zurückziehen, Korrekturhinweis senden. |
| C4 | „Der optionale Aufbau nutzt Python.“ | Freigegebenes Zusatzblatt, Zielgruppe „Aufbauübung“ | Belegt, aber eng begrenzt | Empfehlung für den Zusatzblock, keine Voraussetzung für Grundlagen. | Kontext im Antworttext beibehalten. |
Ein Claim-Ledger ist kein Zertifikat. Es ist ein Arbeitsnachweis: Welche Aussage wurde geprüft, woran, durch welche Rolle, mit welchem Ergebnis und mit welcher verbleibenden Grenze? Ein zweites Teammitglied soll die Prüfung wiederholen können, ohne den gesamten Chatverlauf erraten zu müssen.
6. Das Fragenmodell verändert die Antwort wirklich
Für diesen Artikel ist das Fragenmodell keine Grafik am Seitenrand. Es verändert, was als Antwort gelten darf. Die Reihenfolge A → B → D → C verhindert, dass das Team ein frühes plausibles Fazit als fertige Erkenntnis behandelt.
A – die Ausgangsfrage begrenzen
Die erste Frage „Welche Vorkenntnisse brauche ich?“ ist zu breit, solange unklar bleibt, für welchen Kurs, welche Fassung und welche Art von Teilnahme gefragt wird. A präzisiert:
„Welche Voraussetzungen nennt das freigegebene Programm des Grundlagenkurses in seiner aktuellen Fassung, und welche Aussagen beziehen sich nur auf optionale Aufbauübungen?“
Das verändert den Prüfgegenstand. Nun geht es nicht darum, aus dem Ton der KI auf ihr Wissen zu schließen, sondern einzelne Aussagen mit einer bestimmbaren Quelle und einem Geltungsbereich zu vergleichen.
B – Alternativerklärungen bilden
F-B soll keine Mehrheitsabstimmung und keine automatische Wahrscheinlichkeitsrechnung erzeugen. Es öffnet konkurrierende Hypothesen, die unterschiedliche Evidenz verlangen:
| Hypothese | Was könnte passiert sein? | Welche Beobachtung würde unterscheiden? |
|---|---|---|
| H1 | Die Antwort gibt eine gültige Voraussetzung korrekt wieder. | Die freigegebene Fassung enthält eine ausdrückliche Zugangsvoraussetzung. |
| H2 | Die Antwort vermischt das Grundlagenprogramm mit dem optionalen Aufbau. | Beide Fassungen enthalten die Wörter „Python“, aber mit unterschiedlichem Zweck oder Zielpublikum. |
| H3 | Die Antwort füllt eine Informationslücke mit einer plausiblen Erwartung. | Im freigegebenen Programm findet sich keine entsprechende Regel; die Antwort verweist auf keine präzise Passage. |
Die Hypothesen sind vorläufig. Die KI kann sie erzeugen, doch die Differenz wird anhand der Unterlagen geprüft. Ein Modellvorschlag ist dabei eine Suchhilfe, keine Evidenz. Im Beispiel sprechen die freigegebene Programmfassung und das separate Zusatzblatt für H2. H3 bleibt als mögliche Erklärung für die nicht belegte Empfehlung relevant. H1 wird für den behaupteten Pflichtstatus verworfen.
Gerade diese Gegenprobe ist der Erkenntnisgewinn von F-B: Ohne Alternativen könnte das Team nur fragen, ob die Antwort „richtig“ klingt. Mit Alternativen fragt es, welche Beobachtung zwischen Versionen, Geltungsbereichen und Schlussfolgerungen unterscheidet.
D – Fehlerschleife mit externer Evidenz
F-D hält fest, dass die erste Antwort scheiterte. Die nächste Runde darf den Fehler nicht einfach sprachlich glätten. Sie braucht neue Evidenz oder eine unabhängige Prüfung:
1. Fehler sichern: Originalantwort, Modell-/Systemversion, Eingabe, verwendete Dokumente und Einsatzkontext werden datensparsam dokumentiert. Keine Personen-, Teilnehmer- oder vertraulichen Originaldaten kommen in den Ledger; Rollenbezug, Dokumentreferenz, Version und eine für den Claim nötige redigierte Textstelle genügen. Zugriff und Aufbewahrung richtet das Team am Einsatz aus.
2. Behauptungen atomisieren: Jede Aussage erhält eine eigene Claim-ID. Empfehlungen, Tatsachen, Werturteile und Unsicherheiten werden getrennt.
3. Quelle bestimmen: Für jede Aussage wird die geeignete, freigegebene Quelle gesucht. Versionsstand und Geltungsbereich werden geprüft.
4. Stützung bewerten: Die Quelle muss den konkreten Claim tragen, ihm widersprechen oder die Frage offenlassen. Ein bloßer Themenbezug genügt nicht.
5. Unabhängig gegenlesen: Eine fachkundige Person prüft Claim und Beleg; bei folgenreichen Entscheidungen wird eine Stelle konsultiert, die nicht nur den ersten KI-Text wiederholt.
6. Korrigieren und zurückmelden: Die falsche oder überzogene Aussage wird durch eine begrenzte Auskunft ersetzt. Das Team prüft nach Einsatz, Schadenslage und geltenden Pflichten, ob und wie Betroffene über eine frühere fehlerhafte Auskunft informiert werden.
7. Wiederholung prüfen: Das Team testet, ob die Quelle beim nächsten Lauf korrekt verwendet wird, und protokolliert Abweichungen. Eine einzige erfolgreiche Wiederholung belegt keine dauerhafte Fehlerfreiheit.
Ein hilfreicher Test ist die Bitte an das System, seine Antwort selbst zu überprüfen. Das Ergebnis kann Hinweise liefern, etwa auf eine zitierte Fassung oder eine alternative Lesart. Es ist aber kein unabhängiger Kontrollschritt. Wenn das System die gleiche falsche Voraussetzung erneut verwendet, hat es seine eigene Behauptung nicht durch eine unabhängige Quelle bestätigt. Umgekehrt kann eine selbst erkannte Unsicherheit Anlass sein, den Claim zu stoppen und eine Person hinzuzuziehen. [9]
F-D verändert damit den Status des ursprünglichen Fazits. Das Team verwirft die voreilige Aussage „Python ist Pflicht“ und formuliert stattdessen: „Das freigegebene Grundlagenprogramm nennt keine Python-Voraussetzung. Das Zusatzblatt verwendet Python für eine optionale Aufbauübung. Für eine Auskunft zu einem anderen Kursdurchlauf muss die aktuelle Fassung geprüft werden.“ Diese Antwort ist weniger dramatisch, aber genauer begrenzt und handlungsfähig.
C – eine belastbare Endfrage und ein Arbeitsplan
Erst nach B und D bündelt F-C die Endfrage:
„Welche Aussagen zu Voraussetzungen und Aufbauübungen sind in der freigegebenen Kursfassung belegt, welche stammen aus einer anderen Fassung oder einer Wertung, und wie korrigieren wir eine falsche Auskunft vor der nächsten Teilnahmeentscheidung?“
Ein GROW-Schritt kann daraus den Organisationsplan machen:
Goal: Interessierte erhalten eine zutreffende Auskunft, ohne unnötige technische Zugangshürden.
Reality: Grundlagenprogramm und Zusatzblatt wurden vermischt; die Quellenversion war nicht in der Antwort sichtbar.
Options: Die Antwort wird manuell erstellt, aus einer klar gekennzeichneten freigegebenen Quelle entworfen oder für unklare Fälle an eine zuständige Person weitergeleitet.
Way forward: Vor dem nächsten Einsatz legt das Team eine aktuelle Quellenliste, eine zuständige Rolle, einen Stop-Fall und ein Korrekturprotokoll fest.
GROW strukturiert hier den nächsten Handlungsschritt. Es beweist weder die Richtigkeit der Auskunft noch die Wirksamkeit der gewählten Methode.
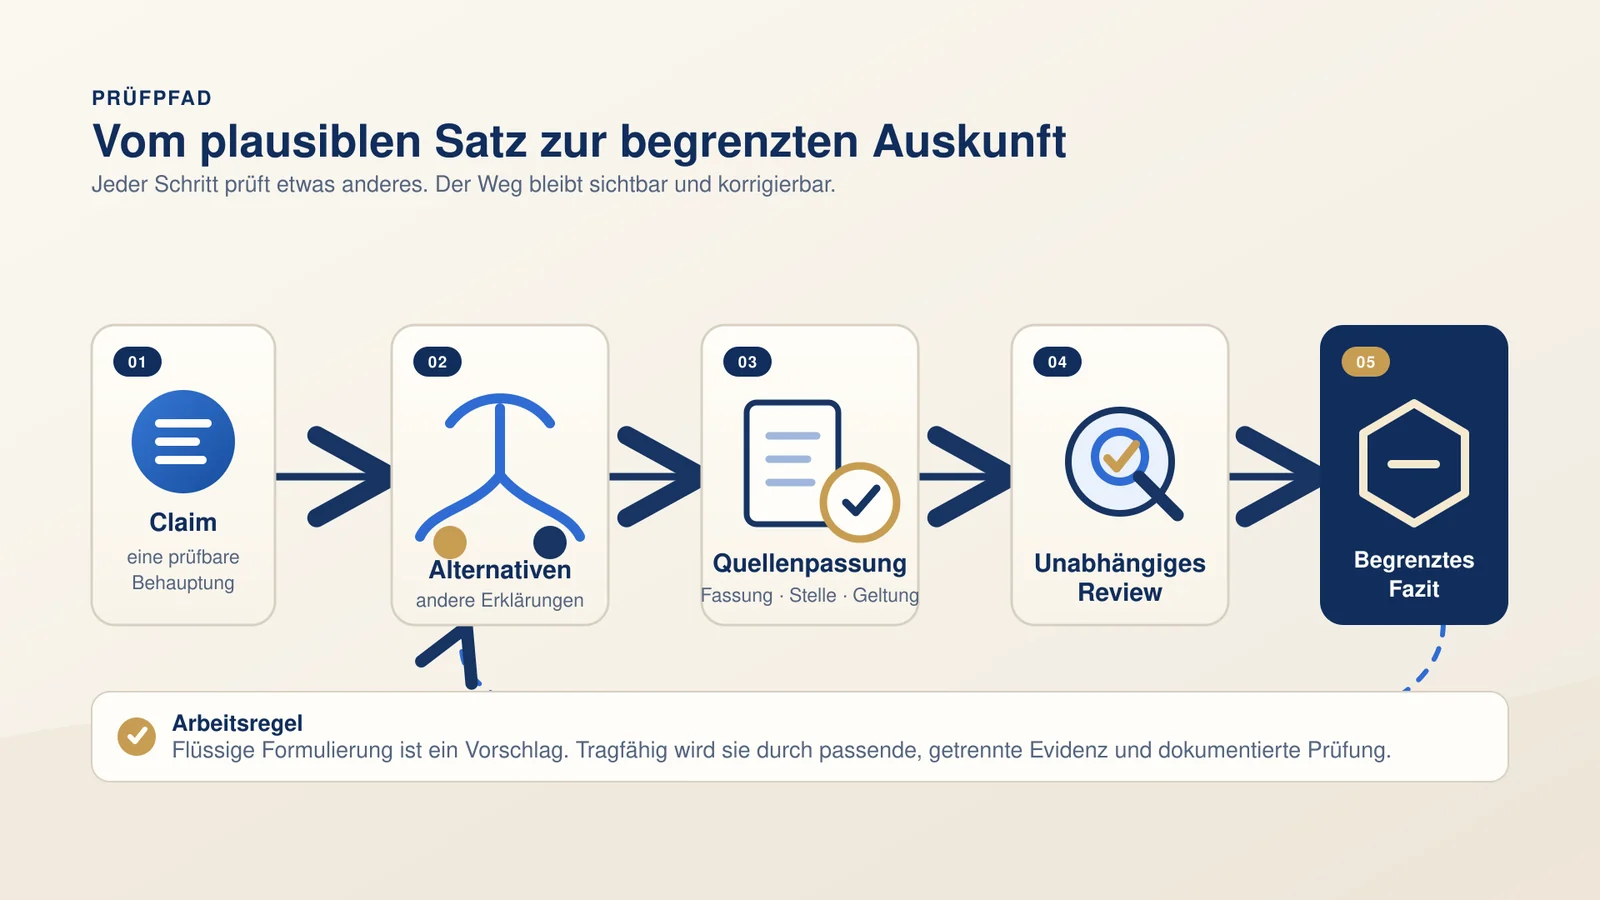
7. Ein Prüfpfad für kleine Teams
Kleine Unternehmen brauchen nicht für jede unverbindliche Formulierung ein mehrstufiges Audit. Sie brauchen eine Regel, die Aufwand und Folgen in ein nachvollziehbares Verhältnis bringt. Das folgende Verfahren ist eine redaktionell entwickelte Arbeitshilfe, keine validierte Risikoskala und keine Rechtskonformitätsprüfung.
Schritt 1: Einsatz und Wirkung beschreiben
Notieren Sie, was die Antwort tun soll: Entwurf, Suche, Zusammenfassung, Empfehlung oder Entscheidungsvorbereitung. Fragen Sie, wer die Ausgabe liest, wer von ihr betroffen ist und welche Handlung dadurch wahrscheinlicher wird. Derselbe sprachliche Fehler hat nicht dieselbe Wirkung, wenn er in einer internen Ideensammlung oder in einer verbindlich wirkenden Kundenauskunft erscheint.
Schritt 2: Prüfbedarf nach Folgen bestimmen
Berücksichtigen Sie mindestens vier Merkmale:
Möglicher Schaden: Kann die Behauptung Zugang, Geld, Sicherheit, Rechte oder eine wichtige Chance beeinflussen?
Reversibilität: Lässt sich eine falsche Entscheidung leicht und ohne bleibende Folge korrigieren?
Betroffenheit: Können Menschen die Ausgabe anfechten, eine andere Auskunft erhalten oder die Nutzung ablehnen?
Evidenzzugang: Gibt es eine aktuelle, autorisierte Quelle und eine Person, die sie fachlich prüfen kann?
Wenn mögliche Folgen schwerwiegend oder schwer umkehrbar sind, reicht eine oberflächliche Plausibilitätsprüfung nicht aus. Fehlt eine geeignete Quelle, ist die korrekte Aktion oft, nicht zu antworten oder weiterzuleiten. „Die KI hat nichts gefunden“ bedeutet weder, dass eine Information falsch ist, noch, dass sie sicher angenommen werden kann.
Schritt 3: Die Behauptung mit der Quelle vergleichen
Vergleichen Sie Aussage für Aussage. Fragen Sie: Belegt die Quelle den gesamten Claim, nur einen Teil oder gar nicht? Passt der Geltungsbereich? Ist die Quelle aktuell und autorisiert? Widerspricht eine andere gültige Fassung? Wird ein Werturteil als Fakt ausgegeben? Diese Fragen lassen sich auf RAG-Systeme ebenso anwenden wie auf einen Chat ohne Retrieval.
Schritt 4: Einen verantwortlichen Handoff festlegen
Eine klare Rollenverteilung kann klein sein: Eine Person verantwortet den Anwendungsfall, eine fachkundige Rolle prüft Quellen und eine zuständige Freigaberolle entscheidet über Einsatz oder Stop. In einem kleinen Betrieb können dieselben Personen mehrere Rollen übernehmen; sie müssen die Prüfschritte trotzdem sichtbar trennen. Ein „Mensch in der Schleife“ hilft nur, wenn die Person Zeit, Wissen, Zugriff und echte Eingriffsrechte hat.
Schritt 5: Korrektur und Lernen ermöglichen
Protokollieren Sie Fehlerarten, betroffene Claims, gefundene Quellenlücken und Korrekturen. Beobachten Sie, ob bestimmte Dokumente veraltet, widersprüchlich oder schwer auffindbar sind. Die organisatorische Ursache kann in unklaren Freigaben, einer schlecht gepflegten Wissensbasis oder einer ungeeigneten Aufgabenverteilung liegen. Ein Modellfehler ist nicht automatisch allein ein Modellproblem.
Das freiwillige NIST-Profil empfiehlt, Quellen und Zitate zu prüfen, Tests nicht unzulässig zu verallgemeinern und Risiken über den Betrieb zu beobachten. Für kleine Teams lässt sich daraus eine proportionale Praxis mit klarer Zuständigkeit, Stop-Weg und Korrekturprotokoll ableiten; die konkrete Ausgestaltung bleibt einsatzabhängig. [10]
8. Die stärkste Gegenposition: Prüfung kostet Zeit
Ein Team kann zu Recht einwenden, dass eine vollständige Belegprüfung für jede KI-Ausgabe zu teuer wäre. Wenn eine KI nur Überschriften sortiert oder einen internen Entwurf sprachlich kürzt, kann ein aufwendiger Freigabeprozess mehr Kosten verursachen als der mögliche Fehler. Prüfkapazität ist begrenzt. Wer jede Aufgabe gleich behandelt, belastet Beschäftigte und kann nützliche Anwendungen verhindern.
Auch eine freigegebene Quelle ist kein allgemeines Wahrheitszertifikat: Sie kann für eine Zugangsvoraussetzung maßgeblich und für eine Wirkungsprognose, einen Wertkonflikt oder einen technischen Sachverhalt unzureichend sein. Das Ledger prüft daher, ob Quelle, Claim, Version und Geltungsbereich zueinander passen; ungelöste Quellenkonflikte bleiben offen.
Diese Einwendung trifft einen wichtigen Punkt. Verantwortungsvolle Prüfung bedeutet nicht, jede Antwort vor jeder Nutzung manuell Wort für Wort abzunehmen. Sie bedeutet, den Zweck und die Folgen zu kennen, die passende Prüftiefe festzulegen und ein sicheres Verfahren für Unsicherheit zu haben. Eine risikoarme, reversible Assistenz kann stichprobenartig und mit klarer Kennzeichnung betrieben werden. Eine Aussage, die Zugang oder Sicherheit berührt, braucht eine stärkere Evidenz- und Freigabekette. Eine Quelle, die nicht gefunden oder geprüft werden kann, sollte eine Grenze der Antwort auslösen.
Technische Maßnahmen können helfen: Suche in freigegebenen Dokumenten, Versionsmetadaten, Hinweise auf fehlende Quellen und stichprobenbasierte Tests. Keine Maßnahme allein beweist Wahrheit. Ein Link kann die falsche Passage zeigen; ein Detektor kann systematische Fehler übersehen; ein Review kann unter Zeitdruck scheitern. Die Kombination hängt von Aufgabe, Daten, Modell, Nutzergruppe und Fehlertoleranz ab.
Die angemessene Gegenantwort auf Prüfkosten ist selektive Prüfung mit expliziten Schwellen. Bei leicht korrigierbaren Entwürfen kann der Aufwand klein bleiben. Wo eine Aussage Zugang oder eine schwer umkehrbare Entscheidung prägt, braucht es stärkere Evidenz und wirksame Aufsicht.
9. Kursübung: Behauptung, Beleg, Urteil
Diese 60- bis 75-minütige Übung ist für eine kleine Lerngruppe oder ein KMU-Team gedacht. Sie benötigt keine echten Teilnehmerdaten. Der fiktive Kursfall aus diesem Artikel reicht aus.
Lernziele
Nach der Übung können Lernende:
1. eine generierte Antwort in mindestens drei einzeln überprüfbare Claims zerlegen; 2. für jede Aussage eine geeignete Quelle, ein Prüfverfahren und einen Geltungsbereich angeben; 3. mit F-B mindestens zwei Alternativerklärungen und unterscheidende Evidenz benennen; 4. eine voreilige Antwort über F-D korrigieren, ohne eine KI-Wiederholung als unabhängige Bestätigung zu werten; 5. eine verantwortliche Rolle, einen Stop-Fall und eine Revisionsbedingung formulieren.
Ablauf
1. Ausgangsantwort lesen (5 Minuten). Eine Person markiert alle Tatsachenbehauptungen, Wertungen und Handlungsratschläge in der Antwort.
2. Claims trennen (10 Minuten). Das Team ergänzt ein Claim-Ledger mit Wortlaut, benötigter Quelle und vorläufigem Status. Jede Person soll verstehen können, was genau geprüft wird.
3. Mit F-B Alternativen bilden (10 Minuten). Kleingruppen erstellen zwei oder mehr Erklärungen. Sie benennen nicht nur Vermutungen, sondern die Beobachtung, die zwischen ihnen unterscheiden würde.
4. Quelle prüfen (15 Minuten). Die Kursleitung gibt drei fiktive Unterlagen aus: das freigegebene Grundlagenprogramm, ein altes Programmdokument und das optionale Python-Zusatzblatt. Die Gruppe identifiziert Fassung, Geltungsbereich und genaue Passage. Keine Quelle wird für mehr verwendet, als sie tatsächlich aussagt.
5. F-D-Schleife durchführen (10 Minuten). Das Team protokolliert den zuerst erwarteten Schluss, den Gegenbeleg, die Korrektur und das, was offen bleibt. Eine erneute Modellantwort darf als Diagnosehinweis dienen; geprüfte Evidenz und ihre dokumentierte Bewertung bilden den Belegweg.
6. Praxisregel entscheiden (10 Minuten). Die Gruppe bestimmt, wer die Auskunft freigibt, wann sie stoppt, wie eine Korrektur mitgeteilt wird und welche Änderung eine erneute Prüfung auslöst.
7. Peer Review (10–15 Minuten). Ein anderes Team prüft, ob jede Tatsachenbehauptung durch die angegebene Stelle wirklich gestützt wird und ob ein Werturteil als Sachinformation erscheint.
Bewertungsraster
| Kriterium | Erfüllt, wenn … |
|---|---|
| Claim-Klarheit | Jede geprüfte Aussage lässt sich unabhängig von den Nachbarsätzen lesen. |
| Quellenpassung | Quelle, Fassung, Fundstelle und Geltungsbereich sind erkennbar. |
| Alternativen | Mindestens zwei mögliche Erklärungen werden mit unterscheidender Evidenz verknüpft. |
| Korrekturfähigkeit | Die erste Aussage wird nicht still überschrieben; Fehler, Korrektur und offene Punkte bleiben nachvollziehbar. |
| Verantwortung | Eine Rolle kann stoppen, eine andere prüfen oder die Entscheidung eskalieren. |
| Betroffenenperspektive | Die Gruppe fragt, wie eine falsche Auskunft Zugang oder Handlungsmöglichkeiten beeinflusst. |
Die Bewertung misst die Qualität der Begründung in dieser Übung. Sie weist nicht nach, dass ein bestimmter Prompt, das Fragenmodell oder ein KI-Produkt allgemein wirksam ist.
10. Wann Konsultation oder Fachberatung dazukommt
F konzentriert sich in diesem Artikel auf die Frage und den Umgang mit Evidenz. Wenn eine generierte Auskunft real genutzt werden soll, erweitert das Konsultationsmodell K die Analyse um betroffene Rollen, Werte, Governance und Feedback: Wer wäre von einer falschen Kursvoraussetzung betroffen, wer pflegt die freigegebene Quelle, und wie fließen Beschwerden zurück?
Die Modellabfolge folgt den deutschsprachigen SAKIZLI-Vorlagen: Fragenmodell F v5 (A → B → D → C), Konsultationsmodell K mit vierstufigem Grundzyklus und fünfstufigen Fallszenarioschritten sowie dem getrennten fünfphasigen Beratungsmodell R. Diese Namen und Phasen beschreiben die Vorlagen; die Anwendung hier ist eine didaktische Übertragung, keine externe Wirksamkeitsvalidierung.
Der Grundzyklus des Konsultationsmodells ist Exploration, Reflexion und Analyse, Entscheidung und Empfehlung, Feedback und Evaluation. Wenn der Fall ein Pilotvorhaben erfordert, können dessen Umsetzung und Abschlussbewertung als weitere Szenarioschritte ausgearbeitet werden. Diese längere Fallsequenz ist nicht mit dem gesonderten fünfphasigen Beratungsmodell R gleichzusetzen. K trägt Governance und Lernen; R übernimmt eine konkrete Fachprüffrage, wenn Vertrag, Recht, Regulierung oder technische Due Diligence betroffen sind. Weder Modell ersetzt Fachprüfung oder belegt seine eigene Wirksamkeit.
Für diesen Artikel kann ein kleiner K-Übergang so aussehen:
| K-Schritt | Konkrete Frage im Fall |
|---|---|
| Exploration | Welche Auskunft wird tatsächlich genutzt, welche Quellen sind freigegeben und wer wäre von einem Fehler betroffen? |
| Reflexion und Analyse | Welche Claims sind empirisch, welche sind wertend, und welche Gegenposition oder Betroffenenperspektive fehlt? |
| Entscheidung und Empfehlung | Bleibt der Assistent auf Entwürfe begrenzt, darf er eng gefasste Fragen beantworten oder muss er weiterleiten? |
| Feedback und Evaluation | Wie werden falsche Antworten gemeldet, korrigiert und nach einer Änderung der Kursunterlagen erneut geprüft? |
Wenn eine Frage reale Vertragsbedingungen oder gesetzliche Teilnahmevoraussetzungen betrifft, wird nicht aus diesem Beispiel eine Rechtsauskunft konstruiert. Das Team übergibt einen präzisen Fachprüfauftrag mit Kontext, Version, Rechtsraum und benötigtem Nachweis an eine qualifizierte Stelle. R ordnet diese Übergabe; es gibt keine pauschale Rechtsfreigabe durch die KI.
11. Die praktische Checkliste vor einer Veröffentlichung oder Entscheidung
☐ Ausgabe in einzelne, überprüfbare Claims zerlegt.
☐ Tatsachenbehauptungen, Werturteile, Prognosen und Empfehlungen markiert.
☐ Für jeden Claim eine aktuelle, autorisierte Quelle oder ein offenes Ergebnis festgehalten.
☐ Versionsstand, Geltungsbereich und konkrete Fundstelle geprüft.
☐ Behauptung und Quelle direkt verglichen; ein Zitat oder Link allein gilt nicht als Prüfung.
☐ Mindestens eine konkurrierende Erklärung und die unterscheidende Evidenz notiert.
☐ Unbelegte Aussage korrigiert, begrenzt oder zurückgehalten; keine stillschweigende Ergänzung.
☐ Auswirkungen auf betroffene Personen und mögliche Ausschlüsse eingeschätzt.
☐ Prüferrolle und Freigaberolle benannt; Stop- und Eskalationsweg praktisch erreichbar.
☐ Korrekturweg für bereits weitergegebene falsche Auskünfte festgelegt.
☐ Grenzen eines Tests und offene Unsicherheit ausdrücklich genannt.
☐ Nur bei tatsächlichem Fachbedarf an Recht, Regulierung oder Vertrag an qualifizierte Beratung übergeben.
Die Liste ist eine Lern- und Arbeitsvorlage, keine Garantie, dass jedes Risiko gefunden oder ein geltendes Regelwerk erfüllt wurde. Ihr Wert liegt darin, einen konkreten Begründungsweg sichtbar zu machen.
12. Was aus diesem Artikel folgt
Eine kohärente Antwort kann als Entwurf nützlich sein. Sie kann Suchbegriffe liefern, Dokumente ordnen, Unterschiede markieren und eine Diskussion anstoßen. Sie ist aber kein Ersatz für die Prüfung dessen, was sie behauptet. Die entscheidende Grenze verläuft zwischen sprachlicher Leistung und nachvollziehbarer Stützung.
Das Fragenmodell hilft, diese Grenze praktisch zu bearbeiten. F-A klärt den Claim und die Quelle, um die es geht. F-B eröffnet konkurrierende Erklärungen, statt die erste plausible Antwort zu bestätigen. F-D macht fehlende Evidenz und Korrektur sichtbar. Erst dann formuliert F-C eine begrenzte Endfrage und einen Arbeitsplan. K übernimmt, wenn aus der Wissensfrage ein Organisationsentscheid mit Betroffenen und Regeln wird. R kommt nur für einen präzisen Fachprüfauftrag hinzu.
Für ein kleines Team bedeutet das nicht, jede KI-Ausgabe zu misstrauen. Es bedeutet, den Belegstandard an der möglichen Wirkung auszurichten, Quellen tatsächlich zu lesen und den Korrekturweg vor dem Einsatz festzulegen. Wenn eine Aussage nicht belegt ist, darf sie offen bleiben. Wenn sie einer maßgeblichen Quelle widerspricht, muss sie korrigiert werden. Und wenn die Folgen schwer wiegen, ist Nicht-Antworten eine vertretbare Entscheidung.
Die Leitfrage für den nächsten KI-Entwurf lautet: „Welche einzelne Aussage willst du machen, welche für diese Frage maßgebliche Evidenz stützt sie, und woran erkennen wir, dass wir sie revidieren müssen?“
Quellen
1. Brown, T. B. et al. (2020). “Language Models are Few-Shot Learners.” Advances in Neural Information Processing Systems 33, 1877–1901; arXiv:2005.14165. https://doi.org/10.48550/arXiv.2005.14165. Verwendet für den eng begrenzten technischen Kontext autoregressiver Sprachmodelle.
2. Peirce, C. S. (1877). “The Fixation of Belief.” Popular Science Monthly, 12, 1–15. Originaltext: https://www.peirce.org/writings/p107.html. Verwendet als philosophische Perspektive auf öffentlich prüfbare Untersuchung und korrigierbare Überzeugungen; nicht als fertiges KI-Prüfverfahren.
3. Maynez, J., Narayan, S., Bohnet, B. & McDonald, R. (2020). “On Faithfulness and Factuality in Abstractive Summarization.” Proceedings of ACL 2020, 1906–1919. https://doi.org/10.18653/v1/2020.acl-main.173. Aufgabe und getestete Systeme begrenzen die Übertragbarkeit.
4. Lin, S., Hilton, J. & Evans, O. (2022). “TruthfulQA: Measuring How Models Mimic Human Falsehoods.” Proceedings of ACL 2022, 3214–3252. https://doi.org/10.18653/v1/2022.acl-long.229. Die Zahlen im Text beziehen sich ausschließlich auf den Benchmark und den damals getesteten Modellbestand.
5. Rashkin, H. et al. (2023). “Measuring Attribution in Natural Language Generation Models.” Computational Linguistics, 49(4), 777–840. https://doi.org/10.1162/coli_a_00486. AIS wird als Evaluationsansatz beschrieben, nicht als automatische Wahrheitsgarantie.
6. Niu, C. et al. (2024). “RAGTruth: A Hallucination Corpus for Developing Trustworthy Retrieval-Augmented Language Models.” Proceedings of ACL 2024, 10862–10878. https://doi.org/10.18653/v1/2024.acl-long.585. Belegt Fehlerfälle in den untersuchten RAG-Ausgaben, nicht die generelle Wirkungslosigkeit von Retrieval.
7. Jiang, Z., Araki, J., Ding, H. & Neubig, G. (2021). “How Can We Know When Language Models Know? On the Calibration of Language Models for Question Answering.” Transactions of the Association for Computational Linguistics, 9, 962–977. https://doi.org/10.1162/tacl_a_00407. Ergebnisse beziehen sich auf damalige Modelle und QA-Aufgaben.
8. Farquhar, S. et al. (2024). “Detecting Hallucinations in Large Language Models Using Semantic Entropy.” Nature, 630, 625–630. https://doi.org/10.1038/s41586-024-07421-0. Erkennt einen begrenzten Fehlertyp; der Ansatz garantiert keine Faktizität.
9. Huang, J. et al. (2024). “Large Language Models Cannot Self-Correct Reasoning Yet.” International Conference on Learning Representations 2024. https://proceedings.iclr.cc/paper_files/paper/2024/hash/8b4add8b0aa8749d80a34ca5d941c355-Abstract-Conference.html. Befund zum intrinsischen Korrigieren ohne externe Rückmeldung in den untersuchten Reasoning-Aufgaben.
10. Autio, C. et al. (2024). Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. NIST AI 600-1. https://doi.org/10.6028/NIST.AI.600-1. Freiwillige, sektorübergreifende Risikomanagement-Leitlinie; keine Rechtsnorm und keine Konformitätsbescheinigung.
Hinweis zur Einordnung: Der Artikel verbindet Primärforschung, ein freiwilliges Risikomanagementprofil und eine philosophische Primärschrift. Die Fallarbeit, Checkliste und das Claim-Ledger sind redaktionell entwickelte Lehrmittel. Ihre Aufnahme in diesen Text behauptet keine wissenschaftliche Validierung oder garantierte Fehlervermeidung.
0 Kommentare
● Kommentare werden geladen…