GraphRAG muss jede Antwort zur Quelle zurückführen
Eine Antwort ist das Ende einer Verarbeitungskette. Evidenz entsteht erst, wenn sich diese Kette in umgekehrter Richtung bis zur gültigen Quelle prüfen lässt.
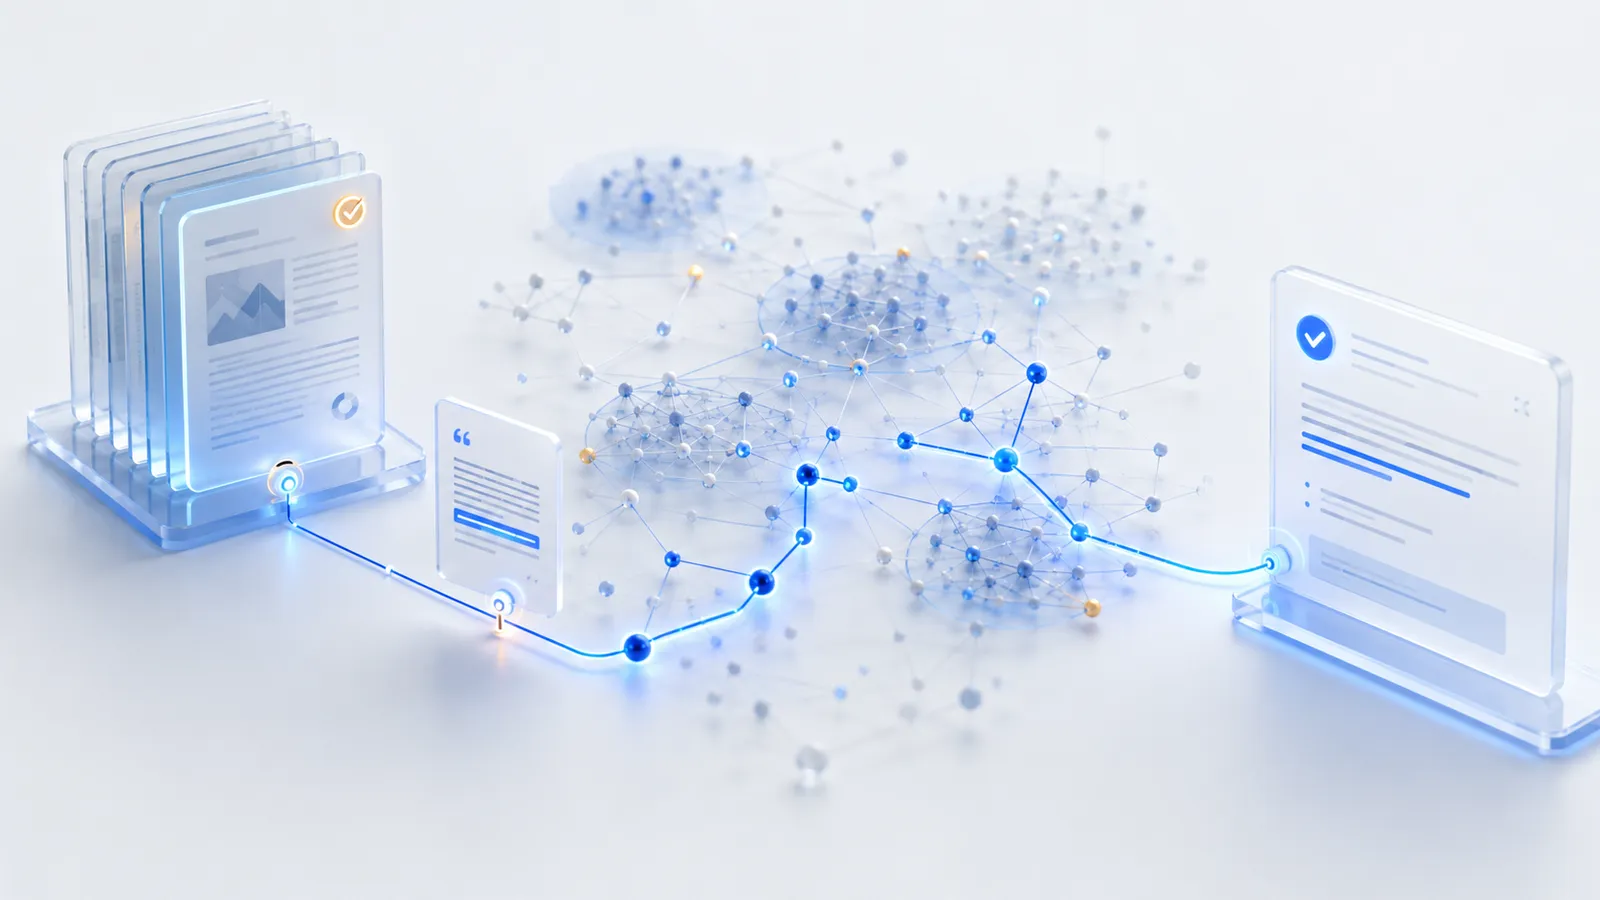
GraphRAG kann Zusammenhänge sichtbar machen, die eine reine Ähnlichkeitssuche nur schwer erfasst. Entitäten werden verbunden, Communities werden gebildet und übergreifende Fragen können auf einer strukturierten Sicht des Korpus beantwortet werden. Gerade diese zusätzliche Abstraktion erzeugt jedoch eine neue Verantwortung: Jede Aussage muss erkennen lassen, aus welchen Dokumenten, Textsegmenten, Extraktionen und Zusammenfassungen sie entstanden ist.
Ein beeindruckender Graph ist dafür nicht genug. Auch eine Antwort mit anklickbaren Zitaten kann methodisch schwach sein, wenn die Zitate nur thematisch ähnlich sind, eine veraltete Version zeigen oder den konkreten Claim nicht stützen. Verlässliches GraphRAG ist deshalb kein Weg vom Dokument zur Antwort in nur einer Richtung. Es ist ein reversibler Evidenzpfad: Antwort → Claim → Graphpfad → Relation → Textsegment → Dokumentversion → Quelle.
Der Index ist eine Kette abgeleiteter Artefakte
Die dokumentierte GraphRAG-Architektur erzeugt aus Rohtexten mehrere Schichten. Dokumente werden in Text Units zerlegt. Daraus werden Entitäten, Beziehungen und gegebenenfalls weitere Claims extrahiert. Communities gruppieren Teile des Graphen; Community Reports verdichten deren Inhalt. Der Query-Mechanismus nutzt anschließend unterschiedliche Kombinationen dieser Artefakte.
Jede Schicht ist nützlich, aber keine ist mit der Primärquelle identisch. Ein Entity-Label kann normalisiert, eine Relation automatisch formuliert und ein Community Report aus vielen Passagen zusammengefasst worden sein. Fehler können sich entlang der Kette fortpflanzen. Deshalb braucht jedes abgeleitete Objekt stabile Referenzen auf seine Eingaben, die verwendete Konfiguration und den Erstellungszeitpunkt. Ohne diese Verbindungen wird der Index zu einem zweiten Wissensbestand, der sich unbemerkt von den Quellen lösen kann.
Stabile Identitäten kommen vor eleganten Graphen
Ein Quellenpfad funktioniert nur, wenn Objekte eindeutig identifizierbar sind. Eine URL allein reicht selten aus: Inhalte können sich ändern, Dateien können denselben Namen tragen und Richtlinien können in mehreren Fassungen vorliegen. Ein robustes System trennt deshalb Source ID, Dokument-ID, Versions-ID, Segment-ID, Entity-ID und Relation-ID.
Die Dokumentversion sollte über einen Hash oder eine vergleichbare unveränderliche Kennung mit dem tatsächlich indexierten Inhalt verbunden sein. Zusätzlich gehören Titel, Herausgeber, Erstellungs- und Abrufdatum, Sprache, Gültigkeitsstatus, Zugriffsbereich und supersedierte Versionen in die Metadaten. Wird ein Dokument aktualisiert, darf die neue Fassung die alte nicht stillschweigend überschreiben. Sonst zeigt der Graph scheinbar denselben Pfad, obwohl sich seine Grundlage verändert hat.
Text Units brauchen präzise Anker
Ein Segment ist nur dann zitierfähig, wenn es innerhalb der Quelle wiedergefunden werden kann. Seitenzahl, Abschnitt, Überschrift, Absatz oder Zeichenbereich sind mögliche Anker. Bei HTML-Inhalten können stabile Selektoren oder gespeicherte Snapshots helfen. Bei Audio- und Videomaterial sind Zeitstempel erforderlich. OCR-Ergebnisse sollten auf die Bildseite und möglichst auf die erkannte Region zurückweisen.
Der sichtbare Ausschnitt darf den Sinn nicht verfälschen. Ein Satz kann von einer Einschränkung im vorherigen Absatz abhängen oder Teil eines Gegenbeispiels sein. Deshalb sollte ein System neben dem Treffer auch benachbarte Passagen und die Dokumenthierarchie verfügbar machen. Chunking dient der Suche; es darf nicht die Beweisgrenze definieren.
Eine Relation braucht eigene Provenienz
Graphen verleiten dazu, Kanten als Tatsachen zu lesen. Tatsächlich kann eine Kante aus sehr unterschiedlichen Verfahren stammen: explizite Tabellenbeziehung, fachlich gepflegte Regel, Ko-Vorkommen, statistische Ähnlichkeit oder automatische Extraktion. Diese Herkunft verändert ihre Bedeutung fundamental.
Eine Relation sollte deshalb Typ, Richtung, Gültigkeitsbereich, Extraktionsmethode, Konfidenz und Quellpassagen tragen. Bei mehreren Quellen müssen Unterstützung und Widerspruch getrennt sichtbar bleiben. Zwei Passagen, die dieselben Entitäten nennen, belegen noch keine kausale Beziehung. Die Kante ist ein navigierbares Analyseobjekt; erst die referenzierten Passagen erlauben eine fachliche Bewertung.
Entity Resolution kann den Quellenpfad verbessern oder zerstören
Mehrere Schreibweisen können dieselbe Entität meinen. Umgekehrt können identische Namen verschiedene Personen, Produkte oder Organisationen bezeichnen. Entity Resolution führt Varianten zusammen und verhindert fragmentierte Graphen. Ein falscher Merge verbindet jedoch Quellen, die nicht zusammengehören, und erzeugt überzeugende, aber falsche Pfade.
Deshalb müssen Aliasregeln, Merge-Entscheidungen und Split-Korrekturen versioniert werden. Für kritische Entitäten ist ein Human Review sinnvoll. Der Query-Pfad sollte erkennen lassen, ob eine Identität direkt aus einer Quelle stammt, algorithmisch abgeleitet oder manuell bestätigt wurde. Die Möglichkeit, einen Merge rückgängig zu machen und abhängige Artefakte neu zu berechnen, gehört zur Datenarchitektur.
Community Reports sind Orientierung, nicht Primärbeleg
Global Search nutzt Community Reports, um Fragen über ein gesamtes Korpus zu beantworten. Das ist leistungsfähig, weil ein einzelner Query-Vektor für abstrakte Fragen wie „Welche übergreifenden Themen prägen den Bestand?" wenig eindeutige Anhaltspunkte liefert. Die Reports komprimieren jedoch bereits komprimierte und extrahierte Informationen.
Eine globale Antwort kann daher eine lange Ableitungskette besitzen. Sie sollte zeigen, welche Reports berücksichtigt, wie Zwischenantworten bewertet und welche Quellbereiche schließlich verwendet wurden. Ein Report kann einen Suchraum priorisieren; als alleiniger Beleg für eine konkrete Aussage ist er oft zu weit von der Quelle entfernt. Für wichtige Claims muss der Pfad bis zu den Text Units und Originaldokumenten weitergeführt werden.
Local, Global und DRIFT erzeugen unterschiedliche Evidenzdistanzen
Local Search kombiniert strukturierte Graphdaten mit Textsegmenten rund um relevante Entitäten. Der Weg zur Quelle ist meist kürzer, doch auch hier können Entity Resolution und Relations-Extraktion Fehler einführen. Global Search arbeitet über Community Reports und Map-Reduce-artige Aggregation; dadurch wird die Evidenzdistanz größer. DRIFT beginnt global und entwickelt lokale Folgefragen, wodurch mehrere Pfade zusammenkommen.
Diese Modi brauchen unterschiedliche Zitierregeln. Eine lokale Faktenantwort sollte konkrete Passagen belegen. Eine globale Synthese sollte sowohl die abgedeckten Communities als auch repräsentative Quellen und Gegenpositionen ausweisen. Eine DRIFT-Antwort sollte den Verlauf der Folgefragen protokollieren, damit erkennbar bleibt, warum bestimmte Regionen des Graphen vertieft und andere verworfen wurden.
Ein Link ist noch kein Claim-Beleg
● Nur für Mitglieder
Lies den vollständigen Artikel und lade alle Dateien mit einer Mitgliedschaft herunter.
Vollständigen Artikel + Downloads freischalten → Abonnieren0 Kommentare
● Kommentare werden geladen…