Chunking, Parsing und die verlorenen Zusammenhänge
Ein Chunk ist kein Stück Text. Er ist eine Aussageeinheit mit Herkunft, Nachbarschaft und einer Rolle im Dokument.
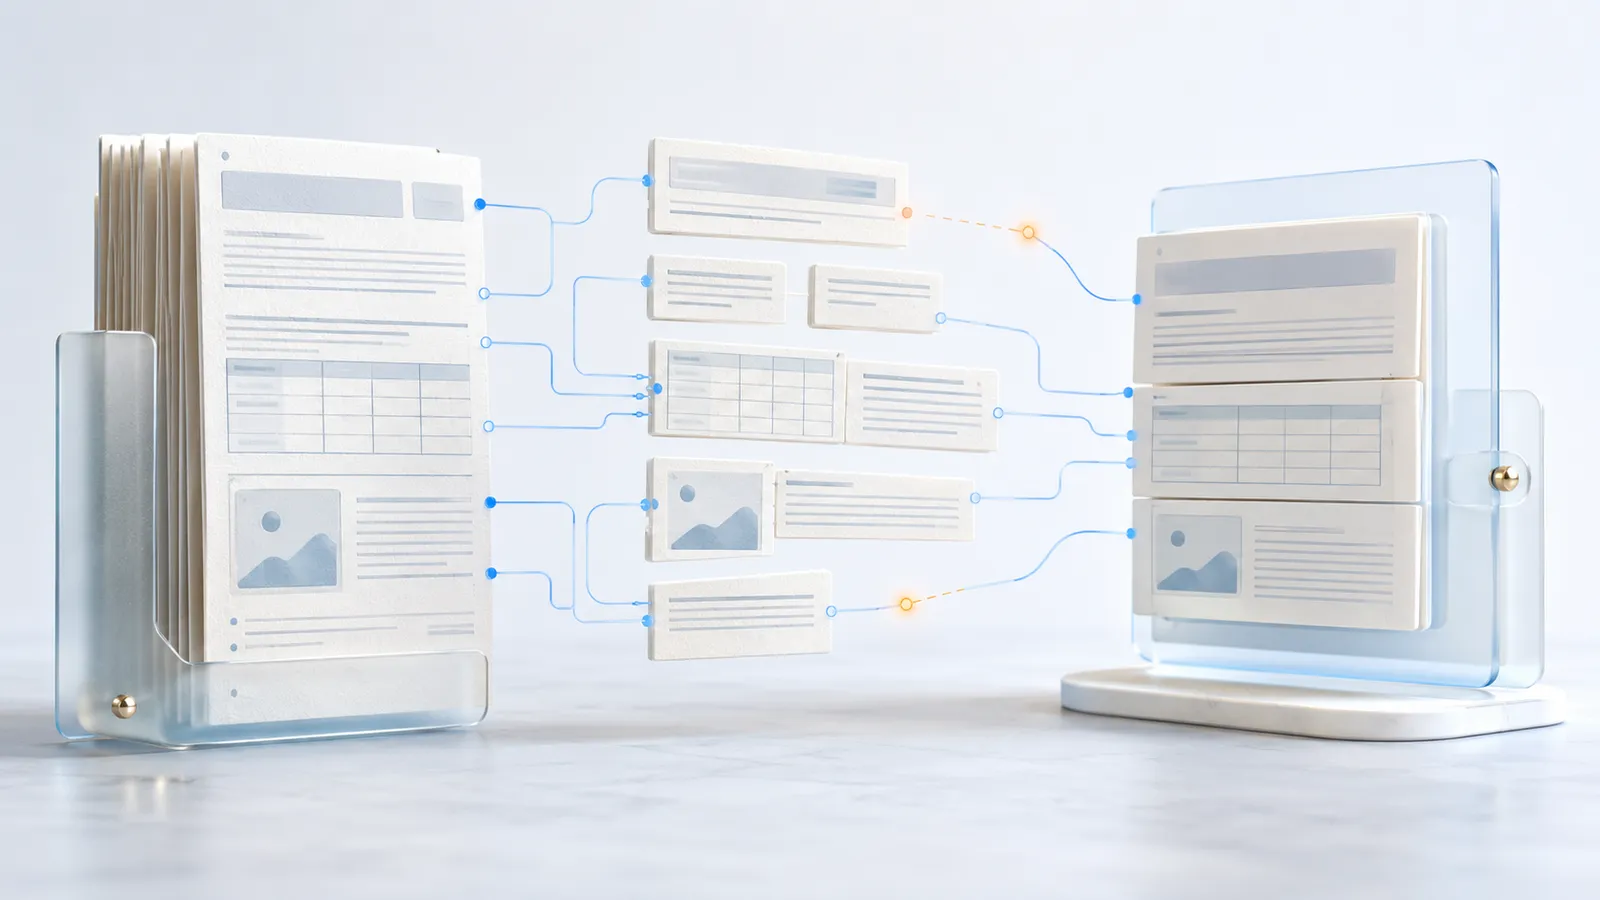
Retrieval-Systeme arbeiten selten direkt mit vollständigen Dokumenten. Sie zerlegen Inhalte in kleinere Einheiten, erzeugen Repräsentationen und suchen später nach passenden Segmenten. Das klingt wie eine technische Routine: Text extrahieren, nach einer festen Zeichenzahl schneiden, Embeddings bilden, fertig. Genau hier entstehen jedoch viele Fehler, die später fälschlich dem Sprachmodell zugeschrieben werden.
Wenn eine Tabellenzeile ohne Spaltenüberschrift, eine Ausnahme ohne zugehörige Regel oder eine Bildunterschrift ohne Abbildung abgerufen wird, ist der Treffer semantisch beschädigt. Er kann ähnliche Wörter enthalten und trotzdem nicht mehr dieselbe Aussage tragen. Chunking ist deshalb keine bloße Speicheroptimierung. Es entscheidet, welche Wissenseinheiten das System überhaupt sehen, vergleichen und belegen kann.
Parsing kommt vor Chunking
Eine PDF-Datei ist zunächst eine Anordnung von Zeichen und grafischen Elementen auf Seiten. Ihre visuelle Ordnung entspricht nicht automatisch einer maschinenlesbaren Lesereihenfolge. Mehrspaltige Texte, Kopf- und Fußzeilen, Seitenzahlen, Fußnoten, Textkästen, Tabellen und eingescannte Seiten können bei einfacher Extraktion durcheinandergeraten.
Parsing rekonstruiert aus diesem Layout eine Dokumentstruktur. Es erkennt Überschriftenebenen, Absätze, Listen, Tabellen, Abbildungen, Bildunterschriften, Fußnoten und Seitenbezüge. Bei Scans kommt Texterkennung hinzu. Erst nach dieser Rekonstruktion ist sinnvoll bestimmbar, was zusammengehört.
Ein Parser kann ebenfalls irren: Er wiederholt Fußzeilen, verschachtelt zwei Spalten, löst Bindestriche falsch auf oder verwandelt eine Tabelle in unverbundene Wörter. Deshalb sollte er strukturierte Elemente mit Typ, Position, Lesereihenfolge und Konfidenz ausgeben, nicht nur Fließtext. Docling beschreibt ein solches Vorgehen mit Layoutanalyse und Tabellenerkennung. Das konkrete Werkzeug ist austauschbar; das Architekturprinzip ist es nicht.
Dokumente besitzen mehrere Ordnungen zugleich
Ein Dokument hat eine lineare Reihenfolge, eine hierarchische Gliederung und zusätzliche Referenzbeziehungen. Ein Absatz steht nach einem anderen, gehört unter eine Überschrift und verweist möglicherweise auf eine Tabelle drei Seiten später. Reiner Fließtext bewahrt nur die lineare Ordnung.
Für zuverlässiges Retrieval braucht ein Segment zusätzlich seinen Pfad: Dokument → Kapitel → Abschnitt → Element. Dazu kommen Nachbarn, Querverweise und die Version des Ursprungsdokuments. „Es gelten folgende Ausnahmen" ist ohne Überschrift und Vorgänger bedeutungslos. Mit dem Pfad Sicherheitsrichtlinie → Zugriffssteuerung → Externe Konten → Ausnahmen wird der Geltungsbereich sichtbar.
Feste Fenster sind eine Baseline, keine Strategie
Die einfachste Segmentierung schneidet nach einer festen Zahl von Tokens oder Zeichen. Sie ist schnell und reproduzierbar, respektiert aber keine Satz-, Absatz- oder Abschnittsgrenzen. Die Schnittkante kann genau zwischen Regel und Bedingung liegen.
Kleine Chunks erhöhen die thematische Präzision, verlieren aber Definitionen, Einschränkungen und Begründungen. Große Chunks bewahren mehr Zusammenhang, enthalten jedoch mehrere Themen, verbrauchen Kontextbudget und verdünnen die relevante Passage. Es gibt keine universell richtige Größe. Glossareintrag, Vertragsklausel, Tabellenzeile und Methodenkapitel benötigen unterschiedliche Segmentierungsprofile.
Overlap wiederholt einen Teil des vorherigen Segments im nächsten. Das hilft bei kurzen Gedankengängen, erzeugt aber Duplikate und stellt keine Struktur wieder her. Eine Tabellenzeile erhält durch hundert wiederholte Tokens nicht automatisch ihre Spaltenüberschrift. Eine Fußnote bleibt ohne Referenzanker unklar. Overlap ist eine lokale Sicherheitsmarge, kein Ersatz für explizite Beziehungen.
Tabellen sind kleine Datenmodelle
Die Bedeutung einer Tabellenzelle entsteht aus Zeilen- und Spaltenkopf, Einheit, Gruppierung und häufig einer Fußnote. Ein Segment „12 | 18 | 24" sagt nicht, ob Monate, Prozentwerte oder Stückzahlen gemeint sind. Ein brauchbares Tabellensegment enthält Titel, relevante Überschriften, Einheit, Zeilenbezeichnung, Werte, Fußnoten und Quellenposition.
Große Tabellen können in Zeilengruppen geteilt werden, doch jedes Child verweist auf ein Parent-Objekt der vollständigen Tabelle. Für Trendfragen kann eine strukturierte Datenrepräsentation geeigneter sein als reiner Text. Ähnlich bleiben Bildunterschrift, Figure-ID und erklärender Absatz miteinander verknüpft, auch wenn sie getrennt gespeichert werden.
Querverweise erzeugen unsichtbare Abhängigkeiten
„Wie oben beschrieben", „diese Werte" oder „sie gilt nicht für …" sind Verweise. Ein Segment kann grammatisch vollständig erscheinen und trotzdem seinen Bezug verloren haben. Ein Context Packet kann deshalb einen kleinen Primärchunk, den Abschnittspfad, eine kurze Parent-Zusammenfassung und gezielt aufgelöste Referenzen enthalten.
Parent-Child-Modelle trennen Such- und Antwortgranularität. Kleine Children sind gut auffindbar; bei einem Treffer wird kontrolliert der größere Parent oder eine definierte Nachbarschaft nachgeladen. Das ist häufig robuster, als alle Chunks von Beginn an groß zu machen.
Semantische und hierarchische Verfahren
Semantisches Chunking setzt Grenzen dort, wo sich das Thema erkennbar ändert. Es kann bei Fließtext besser funktionieren als starre Fenster, erkennt formale Beziehungen aber nicht immer. Eine robuste Strategie kombiniert harte Strukturgrenzen mit weichen semantischen Signalen.
Late Chunking verarbeitet zunächst einen größeren Zusammenhang und bildet erst danach Repräsentationen für Teilbereiche. Dadurch können Chunk-Embeddings Informationen aus dem Umfeld tragen. Das ist ein relevanter Ansatz, aber keine universelle Reparatur: Falsche Lesereihenfolge, zerstörte Tabellenstruktur oder fehlende Versionen bleiben falsch.
RAPTOR organisiert rekursive Zusammenfassungen in einer Baumstruktur und ermöglicht Retrieval auf mehreren Abstraktionsebenen. Detailsegmente und übergeordnete Synthesen dürfen gemeinsam indexiert werden, bleiben aber unterschiedliche Evidenztypen. Eine Zusammenfassung ist keine Primärquelle; finale Aussagen sollten auf die zugrunde liegenden Passagen zurückführen.
Auch ein großes Kontextfenster beseitigt das Problem nicht. Untersuchungen zum „Lost in the Middle"-Effekt zeigen, dass relevante Information je nach Position in langen Eingaben schlechter genutzt werden kann. Mehr Kontext ist nicht automatisch besserer Kontext. Auswahl, Reihenfolge und Hervorhebung bleiben Engineering-Aufgaben.
Extraktion ist nicht Verständnis
Der erste Verarbeitungsschritt macht Inhalte technisch zugänglich. Bei digitalen PDFs kann Text extrahiert werden; bei Scans ist optische Zeichenerkennung nötig. Tabellen, Spalten, Fußnoten, Überschriften und Lesereihenfolgen müssen erhalten oder rekonstruiert werden. Ein plausibler Textstrom beweist nicht, dass die Dokumentstruktur korrekt erfasst wurde.
Qualität beginnt deshalb mit prüfbaren Extraktionsmerkmalen: Seitenbezug, erkannter Dokumenttyp, Sprache, OCR-Konfidenz, Tabellenanzahl und Warnungen für unlesbare Bereiche. Bei kritischen Quellen sollte der extrahierte Text auf die visuelle Originalseite zurückverweisen. So lässt sich ein Fehler von der späteren Antwort bis zum Scan zurückverfolgen.
● Nur für Mitglieder
Lies den vollständigen Artikel und lade alle Dateien mit einer Mitgliedschaft herunter.
Vollständigen Artikel + Downloads freischalten → Abonnieren0 Kommentare
● Kommentare werden geladen…