Werte ohne eingebauten Norden
Wie Organisationen KI-Entscheidungen begründen, wenn gute Gründe miteinander kollidieren
Ein generatives KI-System kann Formulierungen zu Fairness, Sicherheit oder Verantwortung erzeugen. Eine solche Ausgabe begründet noch keinen moralischen Maßstab. Wird ein System in einem konkreten Arbeitsablauf zum Sortieren, Empfehlen oder Priorisieren eingesetzt, wirken Ziele, Kategorien, Daten und Ausnahmen an der Entscheidung mit. Wer diese Festlegungen als „neutralen Output“ behandelt, macht Werte nicht überflüssig: Er macht sie schwerer sichtbar.
Für kleine Unternehmen, Bildungsteams und Organisationen liegt die Aufgabe deshalb nicht darin, einen künstlichen moralischen Kompass zu finden. Sie müssen nachvollziehbar entscheiden, welche Gründe in einem konkreten Fall zählen, wo eine nicht verhandelbare Grenze liegt, wer Einwände einbringen kann und wann eine frühere Abwägung erneut geöffnet wird. Dabei kann eine Entscheidung begründet sein, obwohl die Beteiligten nicht zu einem einzigen Werturteil gelangen.
Dieser Beitrag entwickelt die Unterscheidung anhand eines vollständig fiktiven Falls: Ein kleiner Weiterbildungsanbieter prüft, ob eine KI aus einem deutschen Ausgangstext vereinfachte und mehrsprachige Fassungen eines internen Lernmoduls erstellen darf. Der Fall dient als Denk- und Übungsmodell. Er beschreibt weder einen realen Betrieb noch echte Lernende oder beobachtete Wirkungen.
1. Die einfache Sprachfrage, die es nicht gibt
„Können wir den Text einfach in weitere Sprachen übertragen und vereinfachen lassen?“ klingt nach einer klar umrissenen Produktionsaufgabe. Eine KI könnte einen deutschen Ausgangstext umschreiben, Fachwörter erklären und Varianten für verschiedene Lernkontexte erzeugen. Doch bereits die Begriffe „einfach“, „verständlich“ und „gleichwertig“ enthalten Wertentscheidungen: Welche Aussage muss in jeder Fassung unverändert bleiben? Wer beurteilt, ob eine Version zugänglich genug ist? Und wessen Aufwand zählt, wenn jede Variante geprüft werden muss?
Der fiktive Anbieter bereitet ein internes Lernmodul zur verantwortlichen KI-Nutzung vor. Das Team möchte Mitarbeitenden mit unterschiedlichen Sprachkenntnissen verständliche Materialien geben. Im ersten Entwurf heißt es: „Alle erhalten denselben Inhalt, nur jeweils in ihrer Sprache.“ Doch „derselbe Inhalt“ ist keine fertige Spezifikation. Ein Satz kann wörtlich übersetzt werden und trotzdem seine Bedeutung verfehlen. Eine erklärende Ergänzung kann das Verstehen erleichtern und zugleich die Aussage verschieben. Vereinfachung kann den Zugang öffnen; sie kann aber auch eine wichtige Bedingung oder einen Zweifel aus dem Text entfernen.
Auch „gleich“ kann mehr als eine Sache bedeuten. Eine gemeinsame Standardfassung sorgt für eine zentrale Referenz und kann Änderungen leichter nachvollziehbar machen. Sie kann aber sprachliche Unterschiede und verschiedene Vorkenntnisse übergehen. Individuell angepasste Erklärungen können Lernenden helfen, fachliche Begriffe in ihrer eigenen Situation einzuordnen. Sie schaffen jedoch zusätzliche Varianten, die sorgfältig auf Bedeutungsabweichungen geprüft werden müssen. Eine professionelle Übersetzung ohne KI bleibt eine dritte Option. Sie kann Qualität sichern, sofern genug Zeit und Fachkenntnis vorhanden sind; sie löst aber nicht automatisch die Frage, welche Begriffe unveränderlich sind und welche Beispiele angepasst werden dürfen.
Die Entscheidung betrifft also nicht bloß den Stil. Sie betrifft Zugang zu Wissen, Vergleichbarkeit der Lernziele, die Autorität einer Ausgangsfassung und die Verteilung von Prüfaufwand. Eine Version bestimmt mit, welche Begriffe sichtbar bleiben, welche Beispiele als normal gelten und welche Lernenden zusätzliche Erklärungen erhalten. Das ist eine strukturelle Möglichkeit, noch kein Beleg dafür, dass eine konkrete Sprachfassung im konkreten Kurs eine bestimmte Wirkung erzeugt.
Eine hilfreiche erste Unterscheidung lautet deshalb: Eine gemeinsame Formulierung kann Vergleichbarkeit ermöglichen; sie legt nicht von selbst fest, ob alle Lernenden damit gleich guten Zugang haben. Und eine angepasste Fassung ist nicht automatisch fairer, wenn sie Bedingungen auslässt oder als verbindliche Regel missverstanden wird. Welche Teile des Materials gleich bleiben müssen und wo Anpassung vertretbar ist, ist eine normative und redaktionelle Frage. Sie lässt sich nicht durch die Wahl eines Übersetzungstools beantworten.
2. Wertepluralismus ist keine Beliebigkeit
Wenn mehrere ernst zu nehmende Gründe miteinander kollidieren, stehen zwei bequeme Reaktionen bereit. Die erste lautet: Es müsse irgendwo eine einzige objektive Rangfolge geben; wenn man nur richtig rechne, werde sie sichtbar. Die zweite lautet: Werte seien persönliche Vorlieben, also gebe es ohnehin nichts zu begründen. Beide Reaktionen verkürzen das Problem.
Der Philosoph Isaiah Berlin bezeichnete seine Position als Wertepluralismus. In seinem Essay „The Pursuit of the Ideal“ argumentiert er, dass Menschen mehrere Güter verfolgen können, die jeweils verständlich und wichtig sind, aber nicht immer in einer abschließenden gemeinsamen Skala aufgehen. Das ist Berlins philosophische Position, keine unbestrittene Gesamttheorie der Ethik. Sein Punkt ist für betriebliche Entscheidungen trotzdem nützlich: Ein Konflikt zwischen etwa Verlässlichkeit, Schadensvermeidung, Selbstbestimmung und Gleichbehandlung muss nicht bedeuten, dass eine Seite bloß irrational ist. Berlin grenzt diese Vorstellung vom Relativismus ab: Unterschiedliche Werturteile sind nicht automatisch bloße Geschmacksangaben; sie können verstanden, kritisiert und mit Gründen verteidigt werden. Berlin, „The Pursuit of the Ideal“, Buchseiten 9–12.
Damit ist nicht gesagt, dass alle Gründe gleich stark sind. Ein Unternehmen kann eine Begründung zurückweisen, weil sie auf einer falschen Tatsachenannahme beruht, eine betroffene Perspektive systematisch ausschließt, eine Schutzgrenze verletzt oder die eigenen Regeln nur bei bestimmten Kundengruppen aussetzt. Pluralismus bedeutet auch nicht, dass jede Entscheidung mit dem Satz „Das sind eben unsere Werte“ erledigt wäre. Er verschiebt vielmehr die Aufgabe: Gründe müssen konkret benannt, ihre Voraussetzungen offengelegt und ihre Folgen überprüfbar gemacht werden.
Hier hilft eine Trennung von vier Ebenen:
1. Empirische Frage: Welche Aussagen, Bedingungen oder Beispiele verändern sich zwischen Ausgangstext und Entwurf? Welche Verständnisfragen entstehen in einer Leseprobe? Welche Rückmeldungen fehlen noch? Das verlangt Textvergleich und passende Rückmeldungen; eine flüssige Formulierung allein ist kein Verständlichkeitsnachweis.
2. Normative Frage: Welche Kernaussagen müssen in jeder Fassung gelten? Wann unterstützt eine Erklärung den Zugang, und wann verschiebt sie bereits die Aussage? Welche Ungleichheit oder welcher Ausschluss wäre vermeidbar? Diese Fragen verlangen Argumente, keine bloße Kennzahl.
3. Institutionelle Frage: Wer legt den semantischen Kern fest, genehmigt Abweichungen oder zieht eine fehlerhafte Fassung zurück? Wer trägt den Prüfaufwand, wer kann widersprechen und wer muss auf einen Einwand reagieren?
4. Offene Frage: Welche Lernperspektiven oder Sprachvarianten sind noch nicht berücksichtigt? Was ist vor einer Verwendung tatsächlich geprüft, und was darf nicht als scheinbare Gewissheit in das Material eingehen?
Wer diese Ebenen vermischt, kann aus „wörtlich gleich“ einen Wertmaßstab machen, aus dem Wunsch nach Zugänglichkeit eine unbelegte Wirkung oder aus einer redaktionellen Entscheidung eine vermeintliche Systemeigenschaft. Die Trennung löst den Konflikt nicht. Sie zeigt, welche Art von Begründung fehlt.
3. Wo Werte in ein KI-Verfahren gelangen
Es ist ungenau, einem KI-System einen eigenen moralischen Kompass zuzuschreiben. Ein System kann Wertbegriffe wiedergeben, Perspektiven vergleichen oder eine Empfehlung erzeugen. Daraus folgt nicht, dass es selbst einen öffentlich begründeten Maßstab besitzt oder institutionelle Verantwortung übernehmen kann. Der Artikel behauptet damit keine abschließende metaphysische Antwort darauf, ob Maschinen jemals moralische Akteure sein könnten. Für den praktischen Einsatz genügt die engere Feststellung: Ziele, Daten, Kategorien, Schwellen, Ausnahmen und Befugnisse werden in einem sozio-technischen Zusammenhang festgelegt und müssen von zuständigen Menschen und Organisationen begründet werden.
Der NIST AI Risk Management Framework 1.0 beschreibt, dass Annahmen, Erwartungen und Entscheidungen von Menschen den KI-Lebenszyklus beeinflussen und Risiken sowie Verzerrungen prägen können. Das Framework weist auch darauf hin, dass bei Kennzahlen und Schwellen Entscheidungen darüber nötig sind, welche Leistungen, Fehler oder Risiken relevant sind. Es ist ein freiwilliges Risikomanagement-Framework, kein Garant für ethische Ergebnisse oder eine universelle Wertordnung. Die OECD-Empfehlung zu KI richtet menschenrechts-, rechtsstaatlichkeits- und demokratiebezogene Prinzipien an die für KI handelnden Akteure. Diese normative Orientierung ist ein wichtiger Mindestbezug. Sie ist aber keine automatische Einzelfallentscheidung und nimmt nicht jede konkrete Abwägung vorweg.
Die wissenschaftliche Debatte warnt vor zwei entgegengesetzten Kurzschlüssen. Erstens ist die technische Umsetzung nicht allein deshalb neutral, weil eine Regel formal erscheint. Selbst, boyd, Friedler, Venkatasubramanian und Vertesi zeigen in ihrer Analyse sozio-technischer Fairness, dass die Wahl einer Abstraktion – also was als Problem, Kategorie oder messbares Ziel behandelt wird – eine normative Position mitbringen kann. Daraus folgt nicht, dass Formalisierung nutzlos sei. Es folgt, dass die gewählte Abstraktion begründet und auf ihre ausgelassenen Zusammenhänge geprüft werden muss. Selbst et al., „Fairness and Abstraction in Sociotechnical Systems“.
Zweitens lässt sich die Frage nicht mit einer Liste anerkannter Prinzipien abhaken. Jobin, Ienca und Vayena untersuchten 2019 einen Korpus veröffentlichter KI-Ethik-Leitlinien. Sie fanden Überschneidungen bei Transparenz, Gerechtigkeit und Fairness, Schadensvermeidung, Verantwortung und Privatsphäre, zugleich aber Unterschiede darin, wie diese Prinzipien ausgelegt, begründet und umgesetzt werden. Die Studie beschreibt Dokumente ihres damaligen Korpus; sie beweist weder weltweite Einigkeit noch die Wirksamkeit einer Leitlinie im Betrieb. Originalartikel und frei zugängliche Autorenversion. Mittelstadt argumentiert ergänzend, dass hochrangige Prinzipien allein keine ethische Praxis garantieren. Das ist eine begründete Kritik an Prinzipien allein, kein Beleg dafür, dass gemeinsame Prinzipien nutzlos wären. Jobin et al.; Mittelstadt.
Für das fiktive Kursteam heißt das: Wenn eine Fassung als „gleichwertig“ markiert wird, muss geklärt sein, welche Bedeutung sie bewahren soll, wer Abweichungen prüft, welche Passagen unverändert bleiben müssen und wie Lernende eine missverständliche Stelle zurückmelden können. Ein Modell kann eine Übersetzung sprachlich überzeugend formulieren. Überzeugende Sprache ersetzt keine Prüfung der zugrunde liegenden Bedeutung.
4. Zwei Textstellen, keine Weltanschauungs-Schablonen
Philosophische Perspektiven werden leicht zu Etiketten verkürzt: „Diese Kultur ist gemeinschaftlich“, „jene Tradition ist individualistisch“, „hier zählt Harmonie, dort Verständlichkeit“. Solche Kurzformeln machen aus internen Debatten scheinbar einheitliche Gruppenstimmen. Ein sorgfältiger Vergleich beginnt kleiner: bei konkreten Texten, ihren Übersetzungen, ihrem historischen Umfeld und ihren Grenzen.
In seiner Lehrübersetzung der Analekten beschreibt Abschnitt 13.23 ein Handeln, das mit anderen in Harmonie steht, ohne bloße Gleichförmigkeit zu suchen. Das kann eine Frage für die Schulungsmaterialien öffnen: Muss eine gemeinsame Lernabsicht überall identische Wörter verlangen, oder kann eine tragende Bedeutung in unterschiedlichen Erklärungen erhalten bleiben? Robert Eno betont, dass die Analekten eine über längere Zeit gewachsene Sammlung sind und seine Übersetzung seine eigene Interpretation darstellt; einzelne Lesarten sind nicht zwingend Konsens. Die Passage repräsentiert daher weder „die konfuzianische Sicht“ noch eine unveränderliche chinesische Wertordnung. Sie liefert eine textgebundene Denkanregung, keine heutige Übersetzungsregel. Analects 13.23, Übersetzung und Kommentar von Robert Eno, besonders S. 71.
Der Qur’an nennt in Sure 30:22 die Verschiedenheit der Sprachen – in der hier herangezogenen englischen Übersetzung zusammen mit der Verschiedenheit der Farben – als eines der Zeichen, über die Menschen nachdenken sollen. Das ist eine konkrete religiöse Textstelle, keine Zusammenfassung islamischer Ethik und kein austauschbares Argument für heutige Bildungspolitik. Ihre theologische Einbettung gehört zu ihrer Bedeutung. Für den fiktiven Kurs kann sie die Frage anstoßen, ob sprachliche Variation als Defekt betrachtet werden muss oder ob sie bei gleicher inhaltlicher Sorgfalt einen Platz in Lernmaterialien haben kann. Der Vers entscheidet diese praktische Frage nicht. Qur’an 30:22, Übersetzung „The Clear Quran“ von Mustafa Khattab.
Die beiden Stellen werden nicht zu einem gemeinsamen „östlichen“ oder „religiösen“ Prinzip addiert. Sie müssen auch nicht dieselbe Antwort geben. Neben Berlin gelesen, zeigen sie vielmehr, warum Wertebegründung ein echtes Gespräch erfordert: Einheitlichkeit, Verständlichkeit, Harmonie und sprachliche Verschiedenheit können jeweils Gründe liefern, die sich in einer konkreten Lernumgebung nicht automatisch decken. Ein Text allein ersetzt weder heutige Auslegung noch die Stimmen derjenigen, die lernen oder das Material verantworten.
Für den Kurs bedeutet das: Lernende sollen nicht raten, welche Kultur „Zugang“ bevorzugt. Sie sollen konkrete Gründe rekonstruieren, Gegenargumente formulieren und markieren, wer in einer Debatte bisher sprechen durfte. Wenn eine Organisation eine Tradition oder religiöse Quelle heranzieht, braucht sie sachkundige Auslegung und darf keine einzelne Person oder Gruppe zur Sprecherin aller erklären.
5. Eine Frage öffnen, bevor man ein Ergebnis bestellt
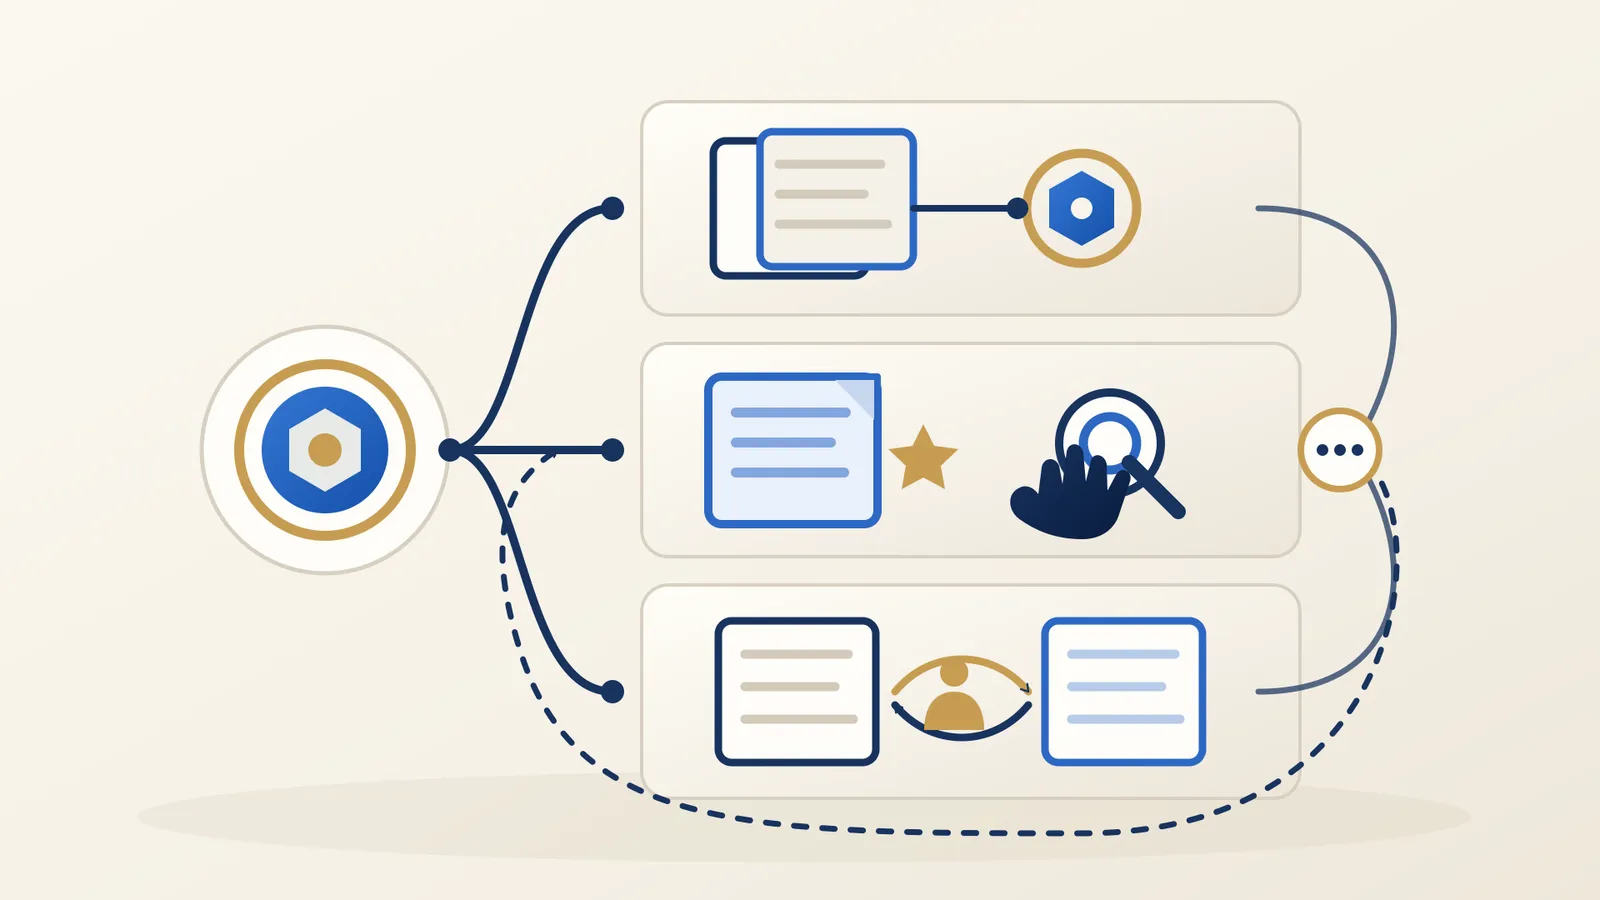
Das Fragenerweiterungsmodell ist in der bereitgestellten deutschen Fassung als Abfolge A → B → D → C aufgebaut. A klärt Begriffe und Annahmen und kann dafür unterschiedliche Fragetechniken nutzen. B entwickelt mehrere Hypothesen, Meta-Fragen und alternative Erklärungen. D hält Iteration, Rückfrage und Fallback offen. C fixiert erst danach die überarbeitete Frage und den erklärten nächsten Handlungsschritt. Dieser Artikel zeigt eine eigens für den Fall formulierte Fragekarte innerhalb von A; er reproduziert kein vollständiges externes Frageprotokoll. Das Modell ist ein Arbeitsverfahren, kein Beleg dafür, dass es in jeder Gruppe empirisch überlegen wäre. (Sakızlı, Fragenerweiterungsmodell, S. 1–3.)
A: Begriffe freilegen, den Denkraum öffnen
Die Ausgangsfrage des Kursteams lautet: „Wie kann KI den Text für alle Lernenden gleich verständlich machen?“ F-A klärt zunächst die Begriffe. Heißt „gleich“ wortgetreu, inhaltlich gleichwertig oder mit denselben Lernzielen? Bedeutet „verständlich“ weniger Fachbegriffe, kürzere Sätze oder andere Beispiele? Wo liegt die Grenze zwischen einer Übersetzung und einer zusätzlichen Erklärung? Soll die KI nur einen Entwurf erstellen oder darf sie auch Aussagen kürzen und umordnen?
Diese Fragen zeigen die Vorannahmen. Die Ausgangsfrage setzt voraus, dass ein Text für alle Lernenden angepasst werden kann, dass die KI die relevanten Unterschiede erkennt und dass „gleich verständlich“ ein Ergebnis ist, das sich ohne die Lernenden definieren lässt. Keine dieser Annahmen ist bereits belegt.
Die eigens erstellte Fragekarte öffnet nun den Denkraum, ohne die spätere Entscheidung vorwegzunehmen:
Welche Aussagen oder Begriffe müssen in jeder Sprachfassung semantisch gleich bleiben? Wo würde eine wörtliche Übersetzung den Inhalt schwerer zugänglich machen? Welche zusätzlichen Beispiele erklären einen Begriff, und welche verändern bereits die Aussage? Wer prüft, ob eine Vereinfachung eine Bedingung, Unsicherheit oder Gegenposition entfernt? Welche Rückmeldung von Lernenden könnte eine Formulierung ändern? Kann ein menschlich erstelltes Glossar oder eine geprüfte Übersetzung den Bedarf ohne KI abdecken? Wer sollte eine Fassung verwenden können, ohne als Vertreterin oder Vertreter einer ganzen Sprachgruppe behandelt zu werden?
Die Fragenkarte ist weder Abstimmung noch Repräsentativitätsnachweis. Sie trennt, was durch Quellen und Textvergleich geprüft werden kann, was eine normative Entscheidung verlangt und wessen Rückmeldung für die nächste Fassung noch fehlt.
B: konkurrierende Hypothesen statt voreiliger Einheitsfassung
F-B verwandelt die Liste nicht in einen Gesamtpunktwert. Es formuliert mindestens zwei vertretbare Hypothesen und lässt eine dritte Option sichtbar:
Hypothese 1 – eine gemeinsame Referenzfassung schützt Vergleichbarkeit. Alle Sprachfassungen orientieren sich eng an einem geprüften Ausgangstext. Das erleichtert Versionskontrolle und kann verhindern, dass zentrale Bedingungen unbemerkt auseinanderlaufen. Die Schwäche: Ein einheitlicher Text ist nicht automatisch gleich zugänglich. Er kann Fachbegriffe oder Vorwissen voraussetzen, die nicht allen Lernenden vertraut sind.
Hypothese 2 – angepasste Erklärungen können Zugangsbarrieren verringern. Beispiele, Begriffslisten und sprachlich vereinfachte Erläuterungen könnten Inhalte für unterschiedliche Lernvoraussetzungen anschlussfähiger machen. Das ist eine plausible Lehrhypothese, kein hier nachgewiesener Effekt. Die Schwäche: Eine Anpassung kann den Sinn verändern. Zusätzliche Varianten kosten Zeit und müssen auf Bedeutungsverschiebungen geprüft werden.
Dritte Option – Übersetzung und Anpassung ohne KI. Fachkundige Übersetzung oder gemeinsame redaktionelle Bearbeitung kann als Vergleich dienen. Sie braucht Ressourcen und kann die Bereitstellung verzögern. Sie ist aber nicht automatisch schlechter, langsamer oder teurer als ein KI-gestützter Weg; das wären konkrete Fragen des jeweiligen Betriebs.
Die Meta-Frage lautet: Welcher semantische Kern muss in jeder Fassung erhalten bleiben, und welche Erklärung darf sich ändern, damit Zugang nicht auf Kosten der Bedeutung geht? Diese Frage verbindet die verschiedenen Werte, ohne sie auf eine gemeinsame Skala zu zwingen.
D und C: den Denkweg sichtbar revidieren
Der erste Entwurf könnte lauten: „Eine gemeinsame Quelle und eine KI-Übersetzung stellen sicher, dass alle dieselbe Information erhalten.“ F-D hält dagegen: Eine gemeinsame Quelle garantiert weder Verständlichkeit noch eine bedeutungsgleiche Übersetzung. Der Begriff „dieselbe Information“ muss erst bestimmt werden. Zugleich wäre es unbelegt, eine angepasste Version als besser zugänglich zu bezeichnen, bevor passende Lernende sie geprüft haben.
Der Einwand verändert die Option. Statt alle Materialien unterschiedslos umzuschreiben, trennt das Team zunächst verbindliche Kernaussagen von erläuternden Beispielen. Es lässt eine menschlich geprüfte Ausgangsfassung bestehen und behandelt KI-Ausgaben höchstens als klar gekennzeichnete Entwürfe. Welche Passagen unverändert bleiben müssen, welche Anpassung vertretbar ist und wer eine Abweichung genehmigt, wird zur offenen Entscheidung.
F-C präzisiert die Arbeitsfrage: Welche Teile eines KI-gestützt vereinfachten oder übersetzten Lernmaterials müssen in ihrer Bedeutung unverändert bleiben, welche Erklärungen dürfen angepasst werden, und welche Prüfung durch Fachkundige und Lernende ist nötig, bevor eine Fassung verwendet wird? Diese Endfrage schreibt weder KI noch eine bestimmte Sprachpolitik vor. Sie macht sichtbar, woran die Entscheidung hängt und welche Rückmeldung eine erneute Prüfung auslösen kann.
6. Konsultation ist eine Entscheidungspraxis, keine Konsensmaschine
Das Sakızlı-Konsultationsmodell verbindet in seiner Grundstruktur Exploration, Reflexion und Analyse, Entscheidungsfindung und Empfehlung sowie Feedback und Evaluierung. Das Modell ist breiter als eine Compliance-Checkliste. Es behandelt Lernziele, unterschiedliche Wissensperspektiven, Ethik/Governance und Rückkopplung. Die vier Schritte des Grundzyklus sind von den ausführlicheren, fünfstufigen Fallszenarien zu unterscheiden, in denen Umsetzung/Pilot und abschließende Bewertung gesondert ausgeführt werden. Die Vorlage selbst ist ein methodischer Entwurf; sie belegt nicht, dass ein Konsultationsformat automatisch fair, wirksam oder vollständig ist. (Sakızlı, Konsultationsmodell, S. 7–8 und 20–33.)
In diesem Lernmaterial-Fall ist Exploration nicht die bloße Einladung möglichst vieler Namen auf eine Liste. Das Team klärt, welche Fassungen erstellt werden sollen, wofür sie verwendet werden, was als verbindliche Kernaussage gilt und wer eine fehlerhafte Version zurückziehen kann. Mögliche Perspektiven sind die redaktionell verantwortliche Rolle, fachlich Lehrende, Personen, die Materialien verwenden, und sprachlich versierte Prüferinnen und Prüfer. Diese Rollen sind Fragen für den fiktiven Entwurf, keine Behauptung, dass eine einzelne Person oder Gruppe alle Lernenden repräsentieren könne.
In der Reflexion und Analyse vergleicht das Team die Gründe, nicht die vermeintliche Lautstärke der Beteiligten. Eine zentrale Referenz kann Abweichungen zwischen Fassungen begrenzen und zugleich sprachliche Hürden übersehen. Angepasste Erklärungen können Zugänge öffnen und zugleich den Kern verändern. Eine ausschließlich menschliche Bearbeitung kann sorgfältig sein und zugleich knappe Ressourcen binden. Hier gehört die stärkste Gegenposition auf den Tisch: Kleine Anbieter können nicht für jede Textvariante unbegrenzt Zeit, Übersetzung und Review bereitstellen. Ein fehlendes oder verspätetes Material kann ebenfalls den Zugang erschweren. Eine umfassende Konsultation ist nicht automatisch besser als ein kurzer, klar begrenzter und korrigierbarer Prozess.
Deshalb muss Konsultation eine Rückmeldung ermöglichen, die das Ergebnis verändern kann. Wenn das Team schon vorab festgelegt hat, dass nur einheitliche Formulierungen zulässig sind, und Rückmeldungen lediglich protokolliert, ist die Reflexion dekorativ. Umgekehrt braucht nicht jede Rückmeldung ein Vetorecht. Das Team muss begründen, wer entscheidet, welche Passagen verändert werden dürfen, welche Kernaussage geschützt wird und warum ein verbleibender Einwand nicht übernommen wurde.
Bei der Entscheidung und Empfehlung kann der Anbieter die Aufgabe begrenzen, statt sofort jedes Modul in mehrere Fassungen zu übertragen. Eine mögliche vorläufige Regel für diesen fiktiven Kurs lautet: Der geprüfte Ausgangstext bleibt die Referenz. Eine KI darf nur nicht verbindliche Erklärungsentwürfe für ein klar bezeichnetes Lernmaterial liefern. Bedingungen, Einschränkungen und zentrale Begriffe werden nicht stillschweigend verändert. Eine fachkundige Person prüft die Bedeutung; Rückmeldungen von Lernenden können eine Fassung erneut öffnen. Menschlich erstellte Übersetzungen oder keine zusätzliche Fassung bleiben gleichwertig zu prüfende Optionen. Das ist eine didaktische Entscheidung, kein Wirksamkeitsnachweis und keine allgemeine Sprachpolitik.
Das Feedback und die Evaluierung fragen nicht nur, ob Texte schneller erstellt werden. Sie prüfen, ob eine Erklärung den Kern erhält, ob zentrale Einschränkungen fehlen, ob Lernende eine unklare Passage melden können und ob einzelne Versionen über längere Zeit auseinanderdriften. Ein einfacher, vorab beschriebener Vergleich kann prüfen lassen, ob ein Beispiel die Kernaussage noch korrekt wiedergibt. Eine solche Leseprobe ist kein Nachweis allgemeiner Verständlichkeit. Ein Reviewtermin oder ein konkreter Widerspruch kann eine neue F-D-Frage auslösen.
Im Unterschied dazu würde das separate Beratungsmodell R erst einsetzen, wenn das Material eine konkrete rechtliche, vertragliche oder fachliche Frage aufwirft. Dann müssten etwa die fragliche Passage, das Produkt, die Rolle und der relevante Kontext abgegrenzt werden. Dieser Artikel führt diese Prüfung nicht vor, sondern markiert die mögliche Übergabe. Eine Konsultation mit Lernenden ist nicht dasselbe wie eine Fachberatung; eine Fachberatung entscheidet ihrerseits nicht anstelle des Teams, welche Wertung es vertreten will. (Sakızlı, 5-Phasen-Beratungsmodell, S. 1–3 und 20.)
7. Die Wertkonfliktkarte als ausgefüllte Arbeitsform
Eine KMU-taugliche Wertkonfliktkarte soll nicht noch ein weiteres abstraktes Framework auf die Arbeit legen. Sie hält auf einer Seite fest, was entschieden wird, welche Gründe kollidieren und wie eine Entscheidung überprüft werden kann. Sie ersetzt weder Beteiligung noch Forschung oder fachliche Prüfung. Der folgende Eintrag ist ein Übungsbeispiel, keine empirisch validierte Vorlage.
Fiktiver Eintrag: Sprachfassungen eines Lernmoduls
| Feld | Arbeitsstand im fiktiven Fall |
|---|---|
| Zweck | Prüfen, ob ein interner Kurs zu verantwortlicher KI-Nutzung in weiteren sprachlichen und einfacheren Fassungen angeboten werden soll. |
| Nicht-Zweck | Keine verbindliche Rechts-, Sicherheits- oder Beschäftigtenrichtlinie durch KI umformulieren; keine Aussage, dass eine Fassung schon verständlich oder gleichwertig sei. |
| Entscheidungsfrage | Welche Teile müssen bedeutungsgleich bleiben, und welche Erklärungen dürfen angepasst werden? |
| Perspektive A | Eine zentrale Referenz schützt Versionskontrolle und Vergleichbarkeit. Risiko: gemeinsamer Wortlaut kann unterschiedliche Lernvoraussetzungen übergehen. |
| Perspektive B | Angepasste Erklärungen können Zugänge erleichtern. Risiko: Bedingungen, Zweifel oder Beispiele verändern unbemerkt die Aussage. |
| Zusatzoption | Menschliche Übersetzung oder ein geprüfter Begriffskatalog ohne KI bleibt eine echte Alternative; Aufwand und Bereitstellungszeit sind offen. |
| Empirischer Belegbedarf | Welche Begriffe sind mehrdeutig? Welche Änderungen treten zwischen Quelle und Entwurf auf? Welche Verständnisfragen bleiben bei einer Leseprobe offen? Keine Wirkung wird hier vorausgesetzt. |
| Normativer Konflikt | Vergleichbarkeit, Zugang, Bedeutungswahrung, Mitsprache und begrenzte Ressourcen können zugleich wichtig sein, ohne in eine einzelne Skala zu passen. |
| Schutzgrenze | Keine KI-Fassung wird als verbindlich oder geprüft gekennzeichnet, bevor fachliche Bedeutung und Sprachfassung geprüft wurden. |
| Vorläufige Empfehlung | Ausgangstext als Referenz behalten; KI höchstens für klar bezeichnete, nicht verbindliche Erklärungsentwürfe einsetzen. Kernaussagen bleiben unverändert; fachkundige und sprachkundige Prüfung sowie Rückmeldung sind Bedingungen, keine nachgewiesenen Qualitätsgarantien. |
| Redaktionelle Zuständigkeit | Im fiktiven Entwurf benennt der Anbieter eine inhaltlich verantwortliche Rolle, die Änderungen und Rücknahme jeder Fassung koordinieren kann. |
| Dissent / Nicht-Einigung | Einwand festhalten, wenn Lernende oder Prüfende darüber uneinig sind, ob eine Vereinfachung den Kern erhält. Keine Gruppe als einheitliche Sprach- oder Kulturstimme behandeln. |
| Einspruch und Korrektur | Verständlichen Weg für Lernende und Lehrende vorsehen, um missverständliche oder verschobene Aussagen zu melden. |
| Revisionsauslöser | Eine Kernbedeutung ändert sich, eine fachliche Bedingung fehlt, eine wiederkehrende Verständnisfrage bleibt ungeklärt oder eine neue Version unterscheidet sich unbemerkt vom Ausgangstext. |
| Review | Version, Quelle, Prüfschritte und Rückmeldungszeitpunkt festhalten. Kein automatisches Gütesiegel nach bloßem Ablauf einer Frist. |
Die Karte enthält absichtlich keine Gesamtpunktzahl. Ein Wert wie „Zugang: 8, Treue zum Ausgangstext: 9“ könnte den Anschein erwecken, sehr verschiedene Gründe ließen sich mit derselben Skala vergleichen. Ein Team kann konkrete Textabweichungen oder offene Rückmeldungen erfassen. Das sind Prüfhilfen, kein vollständiger Maßstab für moralische Angemessenheit und kein empirischer Nachweis, dass alle Lernenden eine Fassung verstehen.
Kompakter Kursdurchlauf in 90 Minuten
Ein Kurs kann die Karte in fünf Abschnitten nutzen:
1. 20 Minuten – F-A-Fragephase: „gleich“, „verständlich“, „vereinfacht“ und „inhaltstreu“ klären; offene Fragen in empirische, normative und organisatorische Punkte sortieren.
2. 15 Minuten – F-B: mindestens zwei begründbare Sprachoptionen und eine menschliche Nicht-KI-Alternative formulieren; Nutzen, Kosten und offene Belege nennen.
3. 30 Minuten – K-Exploration und Reflexion: Lehrende, Lernende und Fach-/Sprachprüfung als konkrete Perspektiven unterscheiden; stärkste Gegenposition und Bedeutungsrisiken prüfen.
4. 15 Minuten – K-Entscheidung: vorläufige Regel mit unveränderlichem Kern, erlaubter Anpassung, Zuständigkeit und Einspruch festhalten.
5. 10 Minuten – Feedback und Revision: benennen, welche Rückmeldung eine Fassung erneut öffnet und wer die Revision veranlasst.
Bewertet werden die Qualität der Begründung, die Trennung von Tatsachen- und Wertfragen, ein fair formulierter Einwand sowie die Revisionsfähigkeit. Bewertet wird nicht, ob alle Teilnehmenden dieselbe Position annehmen. Eine sinnvolle Abschlussfrage lautet: Welche neue Information oder welcher Einwand würde eure vorläufige Empfehlung wirklich ändern? Wenn die Antwort „keiner“ lautet, ist das Verfahren womöglich nicht offen für Prüfung.
8. Die stärkste Gegenposition: kleine Teams können nicht jede Fassung unbegrenzt prüfen
Ein kleiner Weiterbildungsanbieter verfügt nicht über unbegrenzte Zeit und Sprachkompetenz. Jede zusätzliche Variante braucht Pflege. Eine Prüfung durch mehrere Personen kann die Veröffentlichung verzögern und Kapazität binden, die für andere Lerninhalte gebraucht wird. Umgekehrt kann eine schnelle KI-Ausgabe falsche Sicherheit erzeugen: Sie klingt fertig, obwohl niemand die semantische Gleichwertigkeit geprüft hat. Auch die Einladung zu Feedback löst nicht automatisch das Repräsentationsproblem. Wer an einem Kurs teilnimmt, spricht nur für die eigene Erfahrung und nicht für alle Menschen, die dieselbe Sprache verwenden.
Diese Einwände treffen den Kern. Pluralismus darf nicht dazu führen, dass Material aus Angst vor jeder Abweichung unbefristet zurückgehalten wird. Die Antwort ist auch nicht, jede Rückmeldung in ein unbegrenztes Review zu verwandeln. Der Prüfaufwand sollte sich an Tragweite, Bindungswirkung und Korrigierbarkeit der Passage orientieren. Für eine optionale Begriffserklärung kann ein klar gekennzeichneter Entwurf genügen. Eine verbindliche Anweisung, eine Einschränkung oder ein normativer Kern braucht eine sorgfältigere Prüfung. Diese Proportionalitätsregel ist eine redaktionelle Empfehlung in diesem Artikel, keine wörtliche NIST- oder OECD-Vorgabe und kein empirisch validiertes Verfahren.
Ein gemeinsamer Orientierungsrahmen bleibt bedeutsam. Die OECD-Empfehlung richtet menschenrechts-, rechtsstaatlichkeits- und demokratiebezogene Prinzipien an KI-Akteure. Das begrenzt die Vorstellung, jede Organisation könne Grundrechte oder Gleichheit nach Belieben definieren. Doch solche Leitlinien legen nicht für jeden Kurs fest, ob eine erklärende Passage wörtlich übersetzt, vereinfacht oder in ein zusätzliches Beispiel überführt werden soll. Prinzipien begrenzen den Spielraum; die konkrete Begründung bleibt offen.
Auch eine methodisch saubere Karte garantiert keine gute Übersetzung oder gerechte Teilnahme. Dokumentation kann zum Ritual werden, wenn keine Fassung geändert oder zurückgezogen werden kann. Ein fachlicher Review ist unwirksam, wenn er die Sprachfassung nicht prüfen kann. Ein Kursfeedback sagt nicht automatisch etwas über Menschen aus, die nicht teilgenommen haben. Ein einmaliger Vergleich ist keine allgemeine Wirksamkeitsprüfung. Diese Grenzen gehören in die Auswertung und in das spätere Agentic Package, das die Methoden der Serie für konkrete Materialien operationalisiert.
9. Ein begründetes Urteil bleibt überprüfbar
Im fiktiven Arbeitsablauf könnte ein generatives KI-System einen Wertkonflikt beschreiben, mögliche Gründe ordnen oder denkbare Folgen skizzieren. Solche Ausgaben wären Entwürfe zur Prüfung; sie bestimmten weder verbindlich, welche Gründe zählen, noch wer die Grenze setzt. Die Verantwortung für Ziel, Regel, Grenze und Folgen verlagert sich dadurch nicht automatisch in das System. Wer einer Organisation zuschreibt, eine Entscheidung sei „von der KI getroffen“ worden, benennt nicht hinreichend, wer Kriterien gesetzt, Daten freigegeben, Vorschläge angenommen oder Korrekturen unterlassen hat.
Wertepluralismus zwingt ein Team nicht zu Beliebigkeit. Er verlangt, dass ein Zielkonflikt nicht als bloße Rechenlücke oder als persönlicher Geschmack getarnt wird. Die Beteiligten können Gründe austauschen, gemeinsame Grenzen formulieren, eine vorläufige Option wählen und trotzdem dokumentieren, was ungelöst bleibt. Eine Entscheidung gewinnt dadurch keine unfehlbare moralische Autorität. Sie gewinnt eine überprüfbare Begründung und einen Weg, auf neue Einwände oder Befunde zu reagieren.
Für den fiktiven Anbieter beginnt die verantwortbare Arbeit daher nicht mit der Frage, welches Modell den Text am flüssigsten umschreibt. Sie beginnt mit einer präziseren Frage: Welche Bedeutung muss jede Fassung bewahren, wo darf eine Erklärung angepasst werden, wer kann eine Verschiebung erkennen – und welche Rückmeldung würde unsere Entscheidung ändern?
Ein künstlicher Norden ist dafür nicht nötig. Erforderlich sind ein offengelegter Zweck, belastbare Tatsachen, begründete Wertungen, klare Grenzen und eine Organisation, die ihren eigenen Maßstab nicht für naturgegeben hält.
Quellen und weiterführende Primärtexte
1. Isaiah Berlin. „The Pursuit of the Ideal.“ In: The Crooked Timber of Humanity: Chapters in the History of Ideas, 2. Auflage, Princeton University Press, 2013, S. 1–19; besonders Buchseiten 9–12. Online-Text, Wolfson College, Oxford. Philosophische Position; keine fertige betriebliche Entscheidungsregel.
2. National Institute of Standards and Technology. Artificial Intelligence Risk Management Framework (AI RMF 1.0). NIST AI 100-1, 2023, besonders S. 11–13, 23, 40–41. Offizielles PDF. Freiwilliges Framework; kein Konformitäts- oder Wirkungsgarant.
3. OECD. Recommendation of the Council on Artificial Intelligence, OECD/LEGAL/0449, angenommen 2019, geändert 2023 und 2024, besonders Prinzip 1.2. Amtliche konsolidierte Fassung. Normativer Orientierungsrahmen; konkrete Anwendbarkeit hängt von Rolle und Kontext ab.
4. Anna Jobin, Marcello Ienca und Effy Vayena. „The global landscape of AI ethics guidelines.“ Nature Machine Intelligence 1 (2019), S. 389–399. Verlagsartikel; frei zugängliche Autorenversion, Abstract S. 1 und Diskussion S. 14–15 der PDF-Fassung. Dokumentenanalyse eines zeitgebundenen Korpus, keine Messung der Umsetzung oder weltweiten Zustimmung.
5. Brent Mittelstadt. „Principles alone cannot guarantee ethical AI.“ Nature Machine Intelligence 1 (2019), S. 501–507. https://doi.org/10.1038/s42256-019-0114-4. Wissenschaftlicher Perspektivbeitrag zur Grenze prinzipienbasierter Ansätze.
6. Andrew D. Selbst, danah boyd, Sorelle A. Friedler, Suresh Venkatasubramanian und Janet Vertesi. „Fairness and Abstraction in Sociotechnical Systems.“ In: Proceedings of the Conference on Fairness, Accountability, and Transparency (FAT* 2019), S. 59–68. Verlagsartikel; vollständige Autorenversion, besonders gedruckte S. 59–61 (PDF-S. 2–4). Konzeptioneller Beitrag; keine universelle empirische Behauptung über jede Metrik.
7. The Analects of Confucius: An Online Teaching Translation, übersetzt und kommentiert von Robert Eno, Version 2.21 (2015), Buch XIII, Abschnitt 13.23, S. 71. Open-access-Lehrübersetzung der Indiana University. Eno kennzeichnet seine Übersetzung als eigene Interpretation; sie ersetzt keine vollständige textgeschichtliche oder konfuzianische Auslegung.
8. Qur’an, Sure Ar-Rūm 30:22; hier mit der englischen Übersetzung „The Clear Quran“ von Mustafa Khattab herangezogen. Text und Übersetzung. Eine Übersetzung und ein Vers bilden nicht die gesamte islamische Ethik oder Auslegung ab.
9. Sakızlı. Fragenerweiterungsmodell, bereitgestellte deutsche Originalfassung, S. 1–3. Belegt die interne Modellstruktur A → B → D → C; kein empirischer Wirksamkeitsnachweis.
10. Sakızlı. Konsultationsmodell, bereitgestellte deutsche Originalfassung, Grundzyklus S. 7–8 und Fälle S. 20–33. Belegt die Unterscheidung zwischen dem vierstufigen Grundzyklus und den fünfstufigen Fallszenarien; kein Validierungsnachweis.
11. Sakızlı. 5-Phasen-Beratungsmodell, bereitgestellte deutsche Originalfassung, S. 1–3 und 20. In diesem Artikel nicht angewandt; erwähnt, um Konsultation und fallbezogene Fachprüfung zu unterscheiden.
Grenzen des Beitrags
Die hier entwickelten Fälle, Karten und Abläufe sind redaktionelle, fiktive Synthesen. Die Wertkonfliktkarte wurde nicht empirisch validiert; der Artikel ist keine Rechts-, Vertrags- oder Systemprüfung. Ein tatsächlicher KI-Einsatz erforderte eine neue Prüfung des konkreten Arbeitsablaufs, der Daten, Rollen, betroffenen Personen, einschlägigen Anforderungen und verfügbaren Korrekturmöglichkeiten.
0 Kommentare
● Kommentare werden geladen…